 Gemini 4 Link
Gemini 4 Argon 独立实测:谷歌自测表没写的东西,第三方测出来了
谷歌在 2026 年 9 月 30 日发布了自家的一张跑分对照表。同一天,Artificial Analysis 用自己的一套评测也跑了一遍 Argon 并公布了结果。两张表回答的其实是两个问题。
第二张表在同一天出现
谷歌在 2026 年 9 月 30 日的公告末尾附了一张十八行的对照表。同一天,Artificial Analysis 也给出了自己对这款模型的读数,用的是它自己跑的评测,而不是厂商提供的数字。
在 Artificial Analysis 的智能指数上,Gemini 4 Argon 在高推理档位拿到 53 分,与 max 档的 GPT-6 Astra 持平,比 GPT-6.1 Sol 高 1 分。和谷歌自己近一年半的成绩比,跨度更大,比 Gemini 3.1 Pro Preview 的 30 分高 23 分,比 Gemini 3.8 Flash 高 12 分。
这份独立报告由此得出一个结论,谷歌重新回到智能水平前三的位置。Argon 也是谷歌七个多月来第一款高于 Flash 级别的闭源模型,这和谷歌旗舰线十个月的空窗正好对上。
本文数字来自谷歌 2026 年 9 月 30 日的 Gemini 4 Argon 公告,以及 Artificial Analysis 同日发布的独立评测结果。

为什么这一轮要等独立评测
发布前三周,一个标注为 gemini-3.8-flash 的匿名模型出现在公开竞技场的盲测里,在代码、图形和智能体任务上明显强过真正的 Gemini 3.8 Flash。开发者普遍推断这就是 Gemini 4 的早期版本,但显示名一直没有变,谷歌也从未认领。
2026 年 9 月 18 日流传出的一张基准图,把这个未确认的模型排在 GPT-6 Astra 和 Claude Fable 5.1 之前,覆盖长流程编程和计算机操作,还附了一份据称的定价。这些数字在多家媒体之间转了一圈,始终没有落到一款谷歌真正点名过的模型上。
这并不是说那张流出的图是错的,而是说它无法被验证。9 月 30 日出现的东西性质不同,它带着公开的评测框架、写明的推理档位和一份可以拿去对照公开价目表的成本数字。
- 竞技场上的那个马甲显示为 gemini-3.8-flash,谷歌从未确认过它的身份。
- 流传的基准图日期是 2026 年 9 月 18 日,比正式发布早十二天。
- Artificial Analysis 自己跑评测,不转述厂商提供的数字。
每个任务 1.99 美元,便宜来自价目表
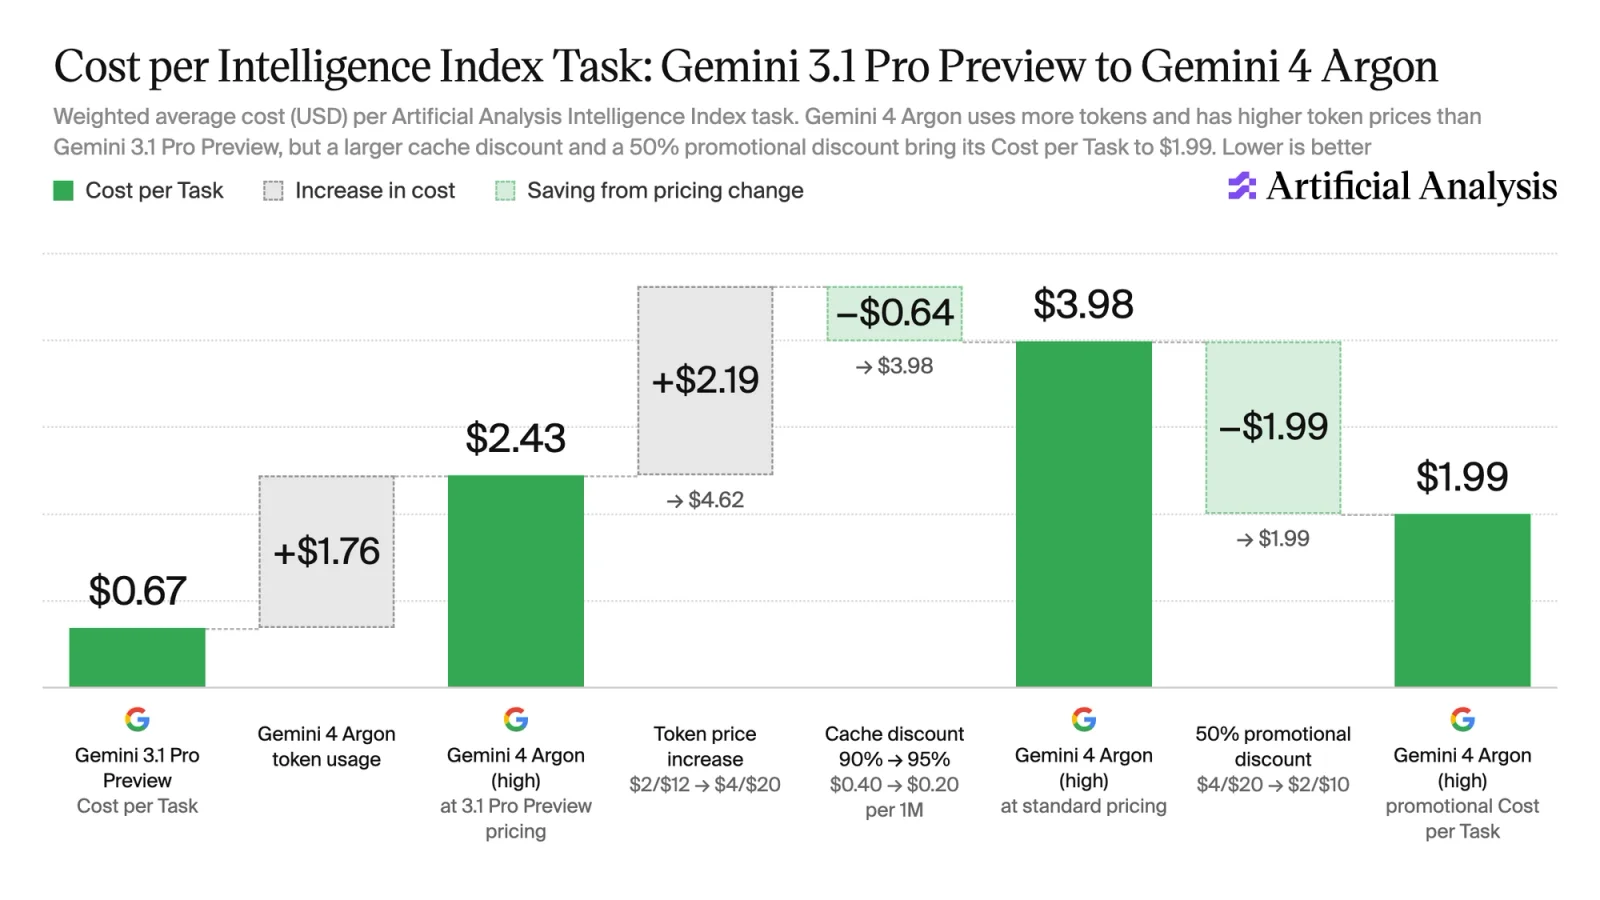
预算真正在意的是每个任务的成本。按当前五折的上市优惠价,Gemini 4 Argon 每个智能指数任务花 1.99 美元,max 档的 GPT-6 Astra 是 3.26 美元。在智能水平相近的前提下,Argon 只花了对手六成的钱。
但和更便宜的那款 OpenAI 模型比,方向就反过来了。同一个评测里,GPT-6.1 Sol 的每任务成本比 Argon 低 2.7 倍。而优惠一旦结束,Argon 的数字会升到 3.98 美元,变成 GPT-6 Astra 的 1.2 倍,不再便宜。
原因不在效率。Argon 平均每个任务输出约 6.2 万 token,GPT-6 Astra 只有 2.7 万,它是靠花更多 token 换到同样的分数,赢在单价上。缓存输入也变便宜了,折扣从 Gemini 3.8 Flash 的九折优惠提到 95%。
| 方案 | 每百万 token 输入 / 输出 | 每个智能指数任务成本 |
|---|---|---|
| Gemini 4 Argon(high)优惠价 | 2 / 10 美元 | 1.99 美元 |
| Gemini 4 Argon(high)标准价 | 4 / 20 美元 | 3.98 美元 |
| GPT-6 Astra(max) | 10 / 50 美元 | 3.26 美元 |
| GPT-6.1 Sol(max) | 官方未按同一口径公布 | 约 0.74 美元,换算所得 |
Sol 那一行并不是官方公布的每任务成本,而是用报告里给出的 2.7 倍关系对 1.99 美元反推出来的,放在这里只是为了看方向,不能当作报价使用。
15% 的幻觉率,同级最低
这份独立报告里最锋利的结论不是能力分数。在 AA-Omniscience 上,这项评测同时考察答得对与不知道时肯不肯说不知道,Gemini 4 Argon 的幻觉率是 15%,是智能指数 45 分以上所有模型里最低的一个,对比之下 GPT-6 Astra 是 51%,GPT-6.1 Sol 是 54%。
把准确率那一半放进来,画面就更细。Argon 答对的比例是 50%,比 Gemini 3.1 Pro Preview 低 5 分,比 GPT-6 Astra 的 63% 低 13 分。而在 AA-Omniscience 的综合分上,三款模型只差 1 分以内,Argon 和 Sol 是 42 分,Astra 是 43 分。
这个拆分说明的是一款宁可拒答也不硬猜的模型。对于无人值守、要连续跑很长任务链的工作来说,答错的代价比答不出更高,所以指数记录下来的这个取舍,价值大过头条上的能力提升。

智能体能力大幅补课,但还不是第一
上一代 Gemini 最弱的一环就是智能体,这次独立跑分显示补课幅度不小。Gemini 4 Argon 在 AutomationBench-AA 上以 78% 排第一,领先 max 档的 Claude Sonnet 5.5 七个百分点,而这项基准考的是能否端到端跑完真实的业务流程。
终端类任务给出的是另一半答案。在 Terminal Bench 4 上,Argon 只有 57%,比 Gemini 3.1 Pro Preview 高 53 分,但同时落后三款模型,Claude Sonnet 5.5 是 64%,Claude Opus 5.5 是 60%,GPT-6 Astra 是 59%。
在考察知识工作的 AA-Briefcase 上,Argon 拿到 1494 Elo,靠的是 65% 的评分细则通过率,这也是 Artificial Analysis 记录到的最高值。不过分项并不好看,分析质量为 1576 Elo,呈现质量只有 1308 Elo。

同一项基准,两套结论
Terminal-bench 4.0 同时出现在两张表里,而它们对谁领先的说法并不一致。谷歌的表把 Argon 放在 57.4%,落后 Claude Opus 5.5 九个百分点。独立跑分把 Argon 放在 57%,落后的是 Claude Sonnet 5.5 的 64%,Opus 5.5 是 60%,GPT-6 Astra 是 59%。Argon 自己的分数几乎一样,围绕它的说法却完全不同。
厂商表格也是某些结果的唯一出处。Harvey 法律智能体基准只在那里出现,Argon 19.6%,GPT-6 Astra 是 5.4%,Claude Opus 5.5 是 3.8%。考察 256k 到 1M 超长上下文的 GraphWalks 也只在官方口径下显示出超过十个百分点以上的领先。这两项都还没有独立复现。
两张表回答的是不同的问题。厂商表说明的是在厂商自己选定的框架和设定下,模型能做到什么。独立表说明的是换个人来跑,它又是什么样。对一款仍然只开放给审核过合作方的模型来说,没有消费者入口,也没有任何可以被重复的会话,只有后一种数字能被房间外的人核查。
| Terminal-bench 4.0 | 谷歌公布的表格 | Artificial Analysis 实跑 |
|---|---|---|
| Gemini 4 Argon | 57.4% | 57% |
| Claude Opus 5.5 | 66.4%,该表中的领先者 | 60% |
| Claude Sonnet 5.5 | 未列入 | 64%,本次实跑的领先者 |
| GPT-6 Astra | 不是该行最高的那个点 | 59% |
两张表都没有错。它们的评测框架、提示词和推理档位都不一样,这正是为什么单独一个排名数字从来不该被单独看待。
拿到第二份意见之后该怎么做
还有一个独立细节解释了长链路任务为什么变得可行。Artificial Analysis 测试了一个叫 Long Decode Continuation 的 Gemini API 特性,它会把长响应暂停,再通过后续调用续写,所以推理可以跑到 100 万输出 token 而不触发请求超时,上一代的输出上限是 6.4 万。上下文窗口为 100 万 token,输入支持文本、图像、视频和语音,输出为文本。
开放范围并没有因为这些数据而改变。Argon 仍然只给 Fairwind 项目中经过审核的防御机构,付费 API 客户和 Google AI Ultra 订阅者是下一批,没有日期。上面所有结果现在都无法在普通账号里复现,这也是把两张表都当作方向性参考的最强理由。
等待期里真正值得做的事,正好是独立数字奖励的那一件。拿今天能调用的模型建一套固定提示词,把输出记下来,等 Argon 开放后用同一套题原样重跑。一款新模型和你自己的基线比,比它和任何别人的表比都更有意义,包括这一篇。
- Argon 目前只能通过 Fairwind 项目接触。
- 输出上限从 6.4 万 token 提升到 100 万 token。
- 现在建好的固定提示词集合,是日后测试 Argon 最省事的方式。
常见问题
Gemini 4 Argon 的独立跑分是多少?
Artificial Analysis 在自家智能指数上给出 53 分,与 GPT-6 Astra 的 53 分持平,比 GPT-6.1 Sol 的 52 分高 1 分。这个分数比 Gemini 3.1 Pro Preview 高 23 分,比 Gemini 3.8 Flash 高 12 分。
为什么独立跑分和谷歌官方数字不一样?
因为两者测的不是同一件事。厂商表格报的是自家设定下跑出来的成绩,Artificial Analysis 用自己的评测集、提示词和评分器重跑一遍,推理档位和外围封装都可能不同,即使基准名字一样也是如此。
Gemini 4 Argon 每个任务要花多少钱?
按当前五折优惠价,Artificial Analysis 测得每个智能指数任务 1.99 美元,同档推理下的 GPT-6 Astra 是 3.26 美元。优惠结束后同一任务升到 3.98 美元,约为 GPT-6 Astra 的 1.2 倍。
为什么 Argon 用的 token 更多反而更便宜?
因为折扣打在单价上,不是打在用量上。Argon 平均每个任务输出约 6.2 万 token,GPT-6 Astra 是 2.7 万,所以省钱来自更低的单价,而不是做得更少。
15% 的幻觉率是什么水平?
在 AA-Omniscience 上为 15%,是智能指数 45 分以上模型里最低的一个。GPT-6 Astra 是 51%,GPT-6.1 Sol 是 54%。不过它的准确率只有 50%,低于 GPT-6 Astra 的 63%。
Gemini 4 Argon 的智能体能力是最强的吗?
还不是。它在 AutomationBench-AA 上以 78% 排第一,领先 Claude Sonnet 5.5 七个百分点。但在 Terminal Bench 4 上只有 57%,落后 Claude Sonnet 5.5 的 64%、Claude Opus 5.5 的 60% 和 GPT-6 Astra 的 59%。
100 万 token 输出上限是怎么实现的?
靠一个叫 Long Decode Continuation 的 Gemini API 特性。它会把长响应暂停,再通过后续调用续写,所以推理可以跑到 100 万输出 token 而不触发请求超时。上一代的输出上限是 6.4 万 token。
本站现在能调用 Gemini 4 Argon 吗?
不能。Argon 目前只开放给 Fairwind 项目中经过审核的防御机构,付费 API 客户和 Google AI Ultra 订阅者是下一批,没有时间表。本站工作台跑的是 Gemini 3.8 Flash,也是目前真正能调用的模型。