 Gemini 4 Link
Gemini 4 Argon im Test: was unabhängige Messungen zeigen, die Googles eigene Tabelle auslässt
Google hat am 30. September 2026 eine eigene Benchmark-Tabelle veröffentlicht. Artificial Analysis hat am selben Tag eine zweite Lesart desselben Modells vorgelegt, aufgebaut auf Auswertungen, die es selbst durchführt. Die beiden Tabellen beantworten unterschiedliche Fragen.
Die zweite Tabelle kam am selben Tag
Google schloss seine Ankündigung am 30. September 2026 mit einer Vergleichstabelle über achtzehn Zeilen. Artificial Analysis veröffentlichte am selben Tag eine eigene Lesart desselben Modells, aufgebaut auf Auswertungen, die es selbst fährt, statt auf Zahlen des Anbieters.
Im Intelligence Index von Artificial Analysis erreicht Gemini 4 Argon 53 Punkte bei der hohen Reasoning-Einstellung. Das ist gleichauf mit GPT-6 Astra bei maximalem Reasoning und einen Punkt vor GPT-6.1 Sol. Der Abstand zu Googles eigener jüngerer Geschichte ist größer: Argon liegt 23 Punkte über Gemini 3.1 Pro Preview mit 30 und 12 Punkte über Gemini 3.8 Flash.
Der unabhängige Bericht zieht daraus eine Schlussfolgerung: Google kehrt als eines der drei besten Labore bei gemessener Intelligenz zurück. Argon ist zugleich das erste proprietäre Google-Modell oberhalb der Flash-Klasse seit mehr als sieben Monaten, was zur Zehnmonatslücke in Googles eigener Flaggschiff-Zeitachse passt.
Die Zahlen in diesem Artikel stammen aus Googles Ankündigung zu Gemini 4 Argon vom 30. September 2026 und von Artificial Analysis, die am selben Tag eigene Auswertungsergebnisse veröffentlicht hat.

Warum ein unabhängiger Lauf das war, worauf man warten musste
Drei Wochen vor dem Start erschien ein anonymes Modell mit der Bezeichnung gemini-3.8-flash in Blindkämpfen auf einer öffentlichen Arena und übertraf das echte Gemini 3.8 Flash bei Coding-, Diagramm- und agentischen Prompts deutlich. Entwickler nahmen weithin an, es sei ein frühes Gemini 4, doch der angezeigte Name änderte sich nie und Google beanspruchte es nie.
Ein Benchmark-Diagramm, das am 18. September 2026 kursierte, setzte das unbestätigte Modell bei langlaufendem Coding und Computer-Nutzung vor GPT-6 Astra und Claude Fable 5.1, mit einem durchgesickerten Preis. Die Zahlen liefen durch mehrere Medien, bevor irgendjemand sie einem von Google tatsächlich benannten Modell zuordnen konnte.
Nichts davon macht das durchgesickerte Diagramm falsch. Es macht es unüberprüfbar. Was am 30. September kam, ist anderer Art, weil es einen veröffentlichten Aufbau, eine angegebene Reasoning-Einstellung und eine Kostenangabe mitbringt, die sich gegen die öffentliche Token-Preisliste prüfen lässt.
- Der Arena-Alias wurde als gemini-3.8-flash angezeigt und von Google nie bestätigt.
- Das kursierende Diagramm war auf den 18. September 2026 datiert, zwölf Tage vor dem Start.
- Artificial Analysis fährt eigene Auswertungen, statt Anbieterzahlen nachzudrucken.
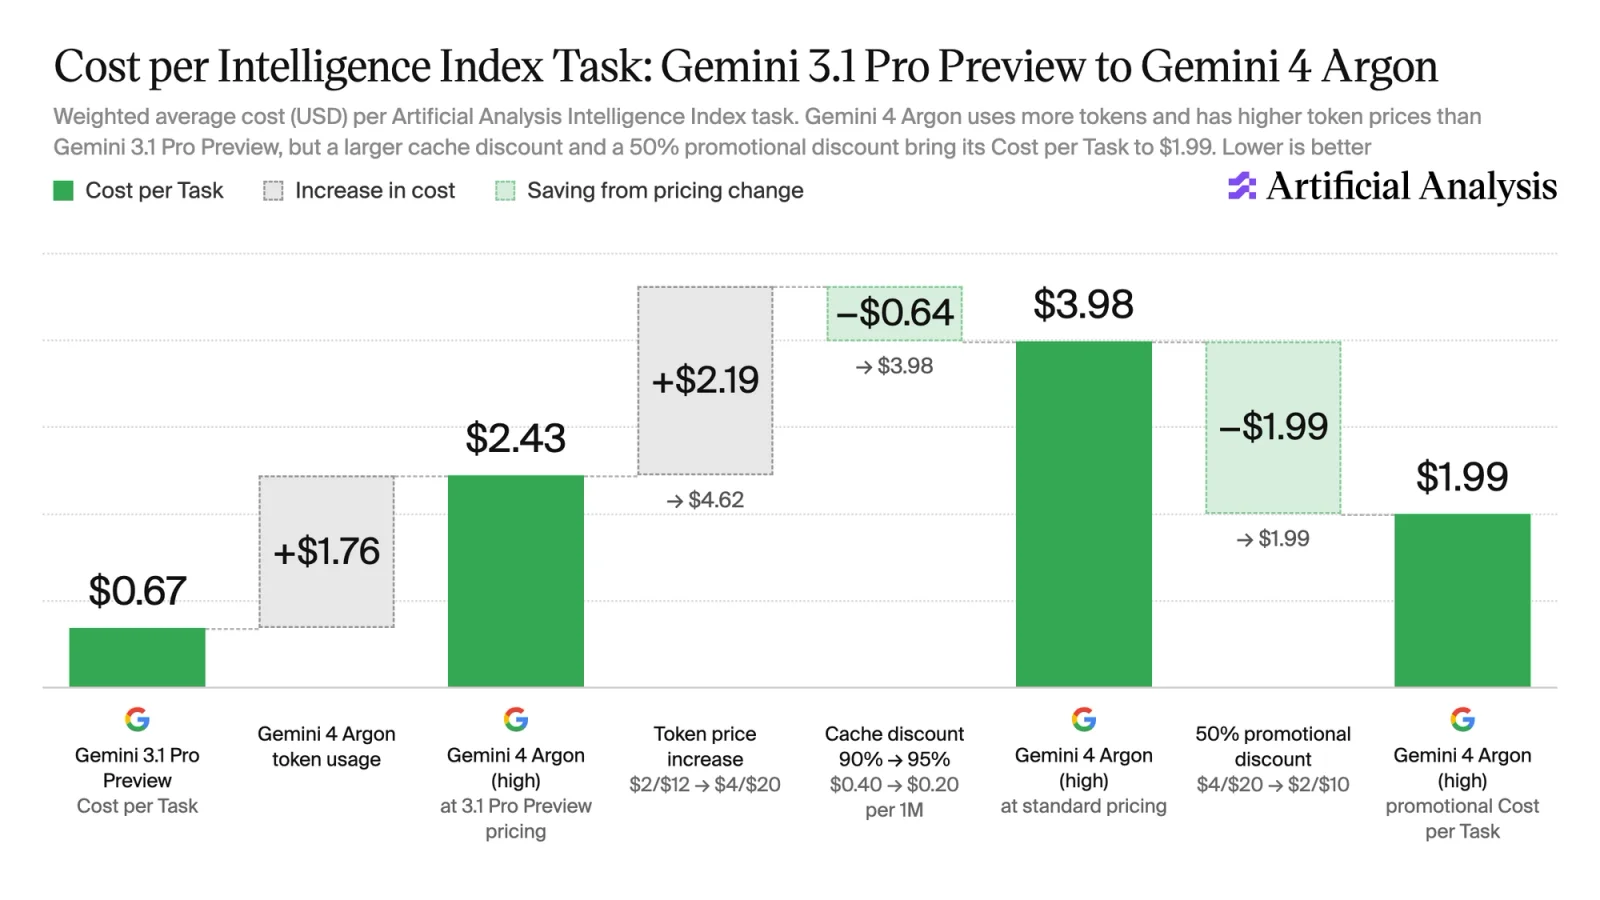
1,99 Dollar pro Aufgabe, und die Ersparnis kommt aus der Preisliste
Kosten pro Aufgabe sind die Zahl, die ein Budget bemerkt. Beim aktuellen Startrabatt von 50 Prozent kostet Gemini 4 Argon 1,99 US-Dollar pro Intelligence-Index-Aufgabe gegen 3,26 Dollar für GPT-6 Astra bei maximalem Reasoning, also 60 Prozent des Preises für ein vergleichbares Maß an gemessener Intelligenz.
Gegen das günstigere OpenAI-Modell kippt der Vergleich. In derselben Auswertung kostet GPT-6.1 Sol pro Aufgabe 2,7-mal weniger als Argon. Sobald die Aktionspreise enden, steigt der Argon-Wert auf 3,98 Dollar, also rund das 1,2-Fache von GPT-6 Astra statt eines Abschlags darauf.
Die Ursache ist nicht Effizienz. Argon mittelt rund 62.000 Ausgabe-Token pro Aufgabe, GPT-6 Astra rund 27.000; es verbraucht also mehr Token für dasselbe Ergebnis und gewinnt über den Stückpreis. Auch zwischengespeicherte Eingabe wurde günstiger und wanderte von 90 Prozent Rabatt bei Gemini 3.8 Flash auf 95 Prozent bei Argon.
| Option | Eingabe / Ausgabe pro Million Token | Kosten pro Intelligence-Index-Aufgabe |
|---|---|---|
| Gemini 4 Argon (high), Aktionspreis | 2 / 10 USD | 1,99 USD |
| Gemini 4 Argon (high), Standard | 4 / 20 USD | 3,98 USD |
| GPT-6 Astra (max) | 10 / 50 USD | 3,26 USD |
| GPT-6.1 Sol (max) | Nicht in derselben Einheit veröffentlicht | Etwa 0,74 USD, abgeleitet |
Der Sol-Wert wird nicht als Kosten pro Aufgabe veröffentlicht. Er ist aus dem angegebenen Faktor 2,7 auf das Argon-Ergebnis von 1,99 Dollar abgeleitet und steht hier, um eine Richtung zu zeigen, nicht als Angebot.
15 Prozent Halluzinationsrate, die niedrigste ihrer Klasse
Das schärfste Ergebnis des unabhängigen Berichts ist kein Fähigkeitswert. Bei AA-Omniscience, das sachliche Richtigkeit mit der Bereitschaft vermischt, bei Nichtwissen abzulehnen, verzeichnet Gemini 4 Argon eine Halluzinationsrate von 15 Prozent. Das ist der niedrigste Wert aller Modelle mit 45 oder mehr Punkten im Intelligence Index, gegen 51 Prozent für GPT-6 Astra bei max und 54 Prozent für GPT-6.1 Sol.
Neben der Genauigkeitsseite wird das Bild feiner. Argon antwortet in 50 Prozent der Fälle korrekt, fünf Punkte unter Gemini 3.1 Pro Preview und dreizehn Punkte unter GPT-6 Astra mit 63 Prozent. Beim kombinierten AA-Omniscience-Wert liegen die drei Modelle innerhalb eines Punktes, mit Argon und Sol bei 42 und Astra bei 43.
Die Aufteilung beschreibt ein Modell, das ablehnt statt zu raten. Bei Arbeit, die unbeaufsichtigt über lange Aufgabenketten läuft, kostet eine falsche Antwort mehr als eine fehlende, was den hier festgehaltenen Tausch wertvoller macht als den Fähigkeitsgewinn in der Überschrift.

Agentische Arbeit hat stark zugelegt und führt trotzdem nicht
Agentische Fähigkeit war der Schwachpunkt der vorigen Gemini-Generation, und der unabhängige Lauf zeigt einen großen Schritt. Gemini 4 Argon führt AutomationBench-AA mit 78 Prozent an, sieben Punkte vor Claude Sonnet 5.5 bei maximalem Reasoning, in einem Benchmark aus echten durchgängigen Geschäftsprozessen.
Terminal-Arbeit erzählt die andere Hälfte. Bei Terminal Bench 4 erreicht Argon 57 Prozent, 53 Punkte über Gemini 3.1 Pro Preview und trotzdem hinter drei Modellen zugleich: Claude Sonnet 5.5 mit 64 Prozent, Claude Opus 5.5 mit 60 Prozent und GPT-6 Astra mit 59 Prozent.
Bei AA-Briefcase, einer Auswertung für Wissensarbeit, erreicht Argon 1.494 Elo auf Basis einer Rubrik-Bestehensquote von 65 Prozent, der höchsten, die Artificial Analysis verzeichnet hat. Die Teilwerte sind weniger schmeichelhaft, mit analytischer Qualität bei 1.576 Elo und Präsentationsqualität bei 1.308 Elo.

Derselbe Benchmark, zwei verschiedene Schlagzeilen
Terminal-bench 4.0 steht in beiden Tabellen, und die beiden sind sich nicht einig, wer führt. Googles Tabelle setzt Argon auf 57,4 Prozent, neun Punkte hinter Claude Opus 5.5. Der unabhängige Lauf setzt Argon auf 57 Prozent, hinter Claude Sonnet 5.5 mit 64 Prozent, mit Opus 5.5 bei 60 Prozent und GPT-6 Astra bei 59 Prozent. Der Argon-Wert ist nahezu identisch, die Geschichte darum nicht.
Die Anbietertabelle ist zugleich der einzige Ort, an dem manche Ergebnisse überhaupt existieren. Harvey's Legal Agent Benchmark erscheint dort mit Argon bei 19,6 Prozent gegen GPT-6 Astra mit 5,4 Prozent und Claude Opus 5.5 mit 3,8 Prozent, und die Langkontext-Auswertung GraphWalks zeigt über das Fenster von 256k bis 1M einen Vorsprung von mehr als zehn Punkten. Beides wurde nicht unabhängig nachgerechnet.
Die zwei Tabellen beantworten unterschiedliche Fragen. Eine Anbietertabelle zeigt, was ein Modell kann, wenn der Anbieter Aufbau und Einstellungen wählt. Eine unabhängige Tabelle zeigt, was es tut, wenn jemand anderes das tut. Bei einem Modell, das weiter auf geprüfte Partner begrenzt ist, ohne Endkundenzugang und ohne Sitzung, die irgendjemand wiederholen kann, lässt sich nur die zweite Art von irgendwem außerhalb des Raums prüfen.
| Terminal-bench 4.0 | Googles gemeldete Tabelle | Lauf von Artificial Analysis |
|---|---|---|
| Gemini 4 Argon | 57,4 % | 57 % |
| Claude Opus 5.5 | 66,4 %, der Führende in dieser Tabelle | 60 % |
| Claude Sonnet 5.5 | Nicht enthalten | 64 %, der Führende in diesem Lauf |
| GPT-6 Astra | Nicht der führende Punkt der Zeile | 59 % |
Keine der beiden Tabellen ist falsch. Sie entstanden unter verschiedenen Aufbauten, Prompts und Reasoning-Einstellungen, und genau deshalb sollte eine einzelne Rangzahl nie für sich gelesen werden.
Was mit der zweiten Meinung anzufangen ist
Ein weiteres unabhängiges Detail erklärt, warum lange Ketten praktikabel wurden. Artificial Analysis testete eine Gemini-API-Funktion namens Long Decode Continuation, die eine lange Antwort pausiert und über Folgeaufrufe fortsetzt. Reasoning kann damit bis zu 1.000.000 Ausgabe-Token laufen, ohne dass die Anfrage in einen Timeout läuft, gegen eine Ausgabegrenze von 64.000 in der vorigen Generation. Das Kontextfenster umfasst 1 Mio. Token, mit Text-, Bild-, Video- und Spracheingabe und Textausgabe.
Der Zugang hat sich dadurch nicht bewegt. Argon ist weiter auf geprüfte Fairwind-Partner begrenzt, zahlende API-Kunden und Abonnenten von Google AI Ultra sind als nächste Gruppen genannt, ohne Datum. Keines der Ergebnisse oben lässt sich derzeit in einem gewöhnlichen Konto reproduzieren, was das stärkste Argument dafür ist, beide Tabellen als Richtungsangabe zu behandeln.
Der praktische Schritt während der Wartezeit ist der, den die unabhängigen Zahlen belohnen. Baue auf den Modellen, die du heute aufrufen kannst, ein festes Prompt-Set, halte die Ausgaben fest und fahre genau dasselbe Set erneut, sobald Argon öffnet. Ein neues Modell an der eigenen Referenz zu messen sagt mehr als dasselbe Modell an der Tabelle von irgendjemand anderem, diese eingeschlossen.
- Argon ist heute nur über das Fairwind-Programm erreichbar.
- Die Ausgabegrenze wandert von 64.000 auf 1.000.000 Token.
- Ein jetzt gebautes festes Prompt-Set ist der günstigste Weg, Argon später zu testen.
Häufige Fragen
Welche Werte erreicht Gemini 4 Argon in unabhängigen Benchmarks?
Artificial Analysis gibt ihm 53 Punkte im Intelligence Index bei der hohen Reasoning-Einstellung, gleichauf mit GPT-6 Astra mit 53 und einen Punkt vor GPT-6.1 Sol mit 52. Das sind 23 Punkte mehr als Gemini 3.1 Pro Preview und 12 mehr als Gemini 3.8 Flash.
Warum weichen die unabhängigen Zahlen von Googles Zahlen ab?
Sie messen Verschiedenes. Eine Anbietertabelle berichtet, wie ein Modell bei Auswertungen abschneidet, die der Anbieter mit eigenen Einstellungen gefahren hat. Artificial Analysis nutzt einen eigenen Aufbau, eigene Prompts und eigene Bewertung, sodass sich Reasoning-Aufwand und Gerüst unterscheiden können, selbst wenn der Benchmark denselben Namen trägt.
Was kostet Gemini 4 Argon pro Aufgabe?
Beim aktuellen Rabatt von 50 Prozent misst Artificial Analysis 1,99 US-Dollar pro Intelligence-Index-Aufgabe, gegenüber 3,26 Dollar für GPT-6 Astra bei maximalem Reasoning. Zum Standardpreis steigt dieselbe Aufgabe auf 3,98 Dollar, rund das 1,2-Fache von GPT-6 Astra.
Warum ist Argon günstiger, obwohl es mehr Token verbraucht?
Weil der Rabatt auf den Preis eines Tokens wirkt und nicht darauf, wie viele davon verbraucht werden. Gemini 4 Argon mittelt rund 62.000 Ausgabe-Token pro Aufgabe, GPT-6 Astra rund 27.000; die Ersparnis kommt also aus einem niedrigeren Stückpreis und nicht daraus, weniger zu tun.
Wie niedrig ist die Halluzinationsrate?
15 Prozent bei AA-Omniscience, der niedrigste Wert aller Modelle mit 45 oder mehr Punkten im Intelligence Index. GPT-6 Astra liegt bei 51 Prozent, GPT-6.1 Sol bei 54 Prozent. Argon antwortet in 50 Prozent der Fälle korrekt und liegt damit unter GPT-6 Astra mit 63 Prozent.
Ist Gemini 4 Argon das beste Modell für agentische Arbeit?
Noch nicht. Bei AutomationBench-AA liegt es mit 78 Prozent vorn, sieben Punkte vor Claude Sonnet 5.5. Bei Terminal Bench 4 erreicht es 57 Prozent und liegt hinter Claude Sonnet 5.5 mit 64 Prozent, Claude Opus 5.5 mit 60 Prozent und GPT-6 Astra mit 59 Prozent.
Was macht ein Ausgabelimit von 1 Mio. Token praktikabel?
Eine Gemini-API-Funktion namens Long Decode Continuation pausiert eine lange Antwort und setzt sie über Folgeaufrufe fort, sodass Reasoning bis zu 1.000.000 Ausgabe-Token laufen kann, ohne dass die Anfrage in einen Timeout läuft. Die vorige Generation begrenzte die Ausgabe auf 64.000 Token.
Kann ich Gemini 4 Argon hier aufrufen?
Nein. Argon ist auf geprüfte Fairwind-Partner begrenzt; zahlende API-Kunden und Abonnenten von Google AI Ultra sind als nächste Gruppen genannt, ohne Datum. Der Chat-Arbeitsbereich dieser Seite läuft mit Gemini 3.8 Flash, dem Modell, das sie heute tatsächlich aufrufen kann.
Miss es an deiner eigenen Referenz
Der Chat-Arbeitsbereich listet die Modelle, die dein Konto aufrufen kann, mit einem serverseitigen Angebot vor jeder Anfrage.
Chat-Arbeitsbereich öffnen