图片反推提示词:从一张图读出可复用的提示词
上传图片,选择需要重点分析的内容,并在复用前检查和修改返回的提示词。下文说明图片反推提示词能还原什么、不能还原什么,不同模型怎么读这段提示词,以及上传图片需要注意的权利问题。
创作设置
图片提示词反推
会按照目标模型的习惯组织提示词。
高级选项
生成结果
完善左侧设置并开始生成,结果会直接显示在这里,无需跳转页面。
效果案例
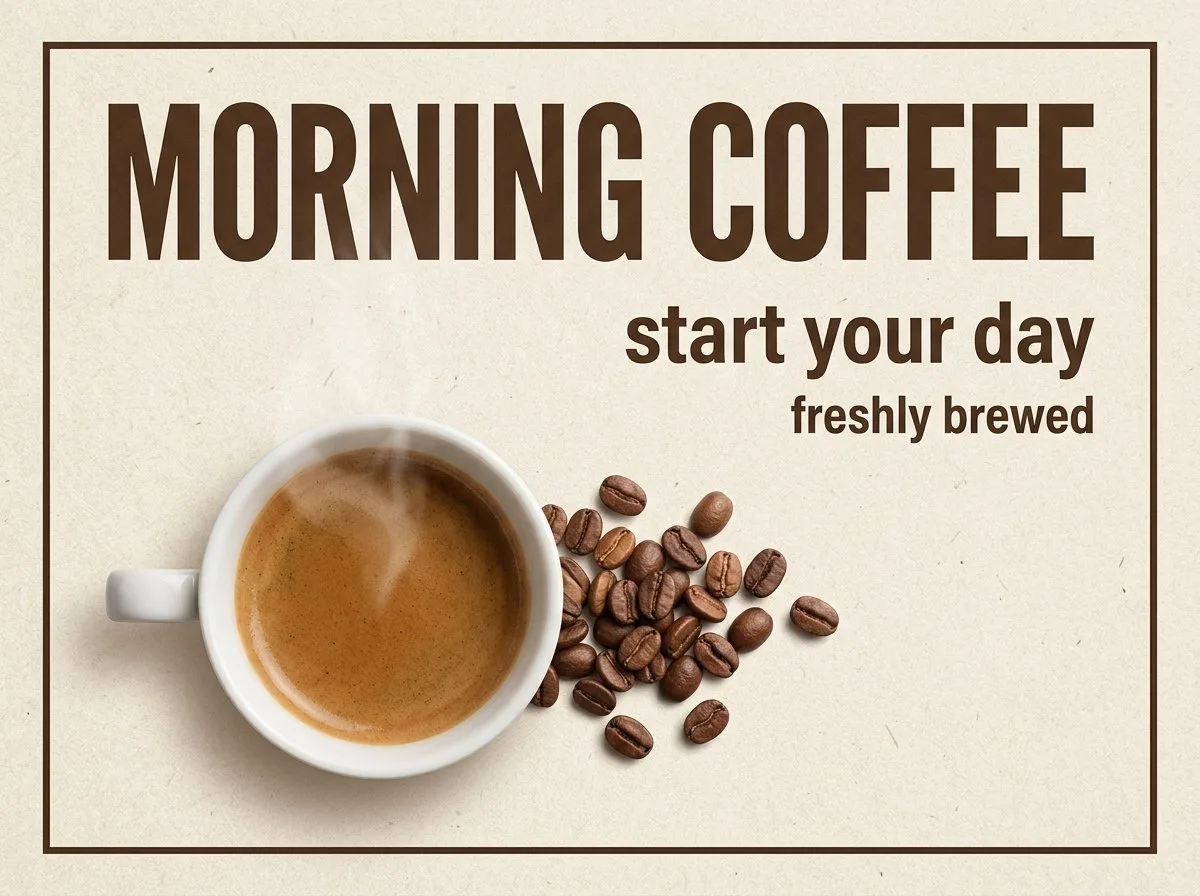
米白纤维质感纸面上的极简咖啡馆海报,四周一圈细深棕双线边框。顶部跨幅的压缩无衬线大标题 MORNING COFFEE 用深咖色;右上角对齐的副标 start your day,下方是小一号的 freshly brewed。左下是一只俯拍的白瓷咖啡杯,可见咖啡油脂的漩涡与一缕淡蒸汽,右侧散落烘焙咖啡豆呈松散弧形。平光棚拍,cream、tan、brown 的大地色系,大量留白,4:3 印刷版式。
一张印刷版式海报。反推提示词要写的是版面与字阶,而不是那只杯子:边框、超大标题与右对齐副标才是它成为海报而不是照片的原因。
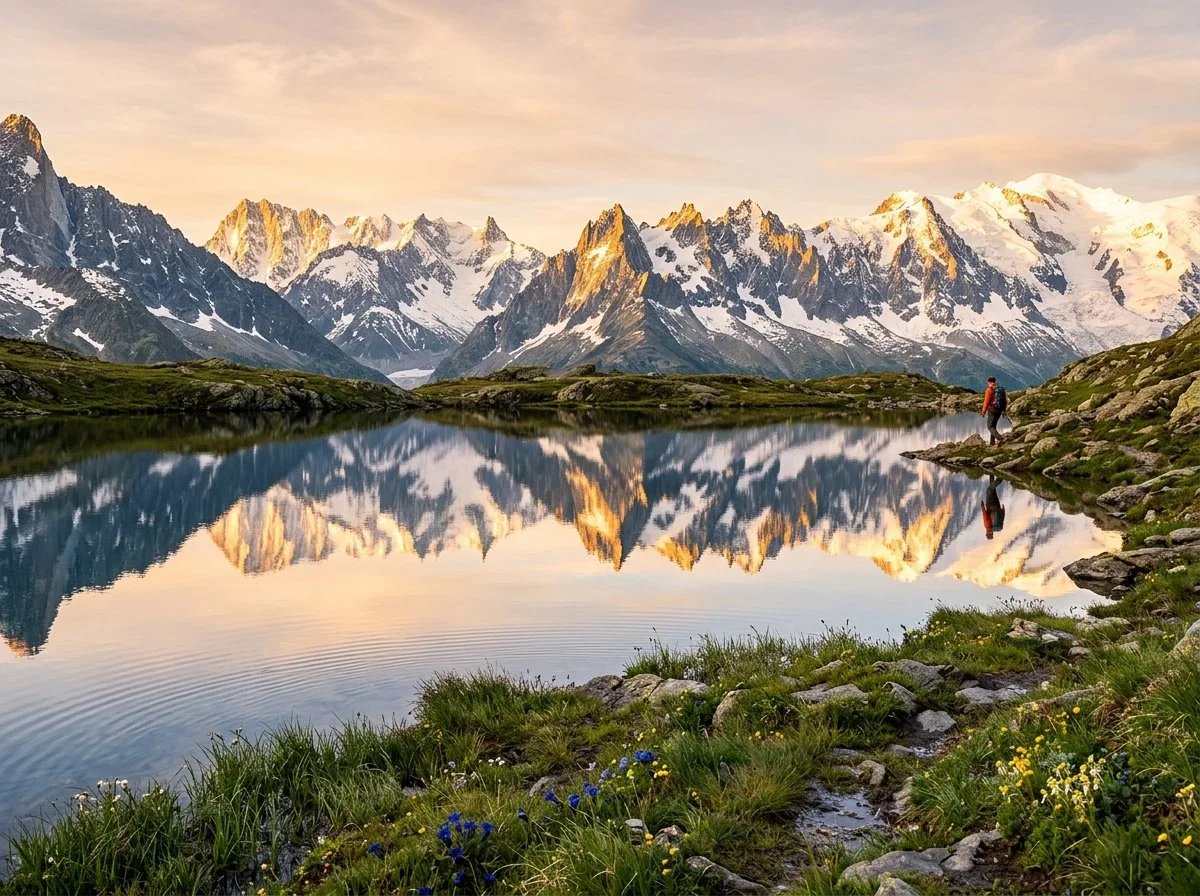
日出时分的高山风景:前景是镜面般静止的冰川湖,整幅宽度倒映着锯齿状雪峰,峰体右侧被暖金色光勾边,天空是淡桃色与蓝色。一名穿红外套、背背包的徒步者走在右侧草岸上,画面中很小。前景有挂露的高山草、石块与散落的蓝黄色野花,最近处的花略微失焦。16mm 超广角质感,大景深,高动态范围,自然调色。
一张风景摄影,几乎所有关键词都能当场核对:镜面倒影、被侧光照亮的峰顶,以及那个提供尺度感的人影。
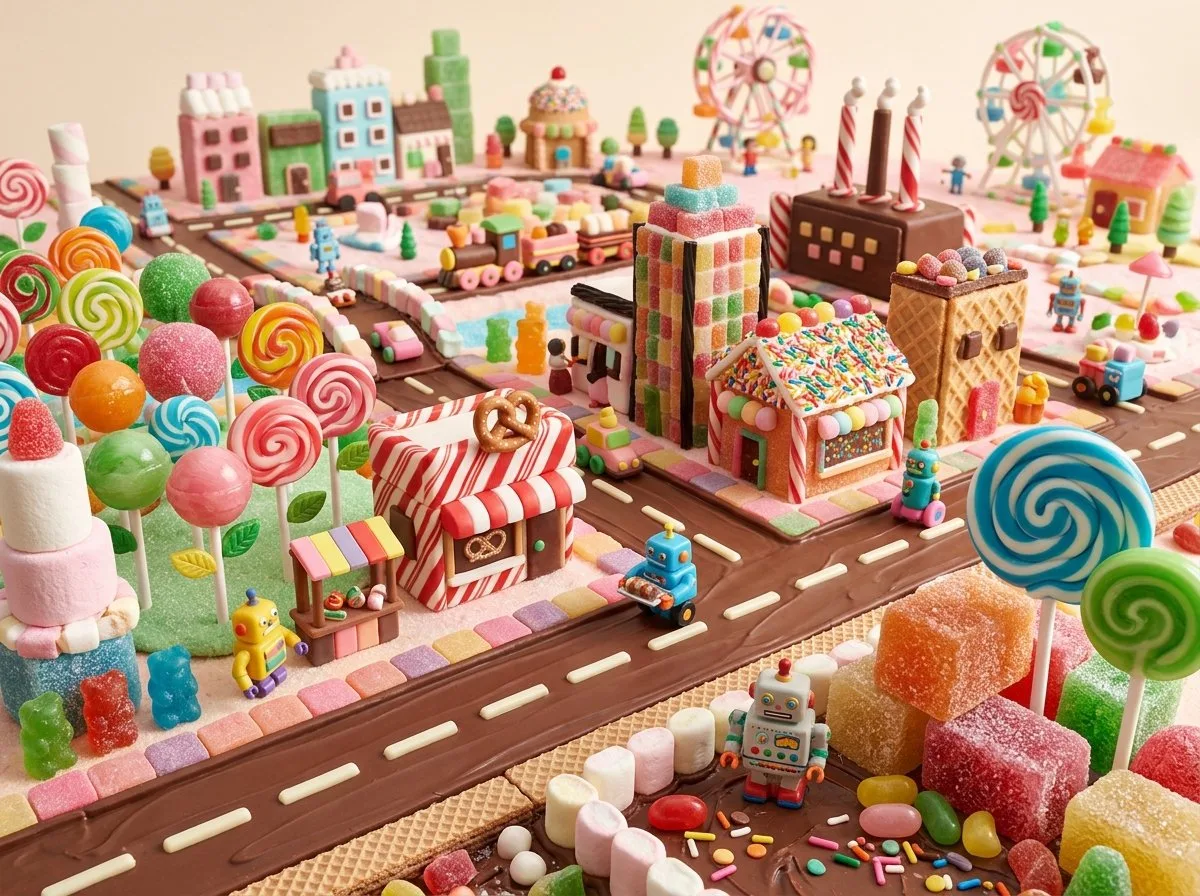
微距微缩摄影:一座完全由糖果搭成的迷你城市。巧克力铺成的马路上画着白色糖霜车道线;建筑是威化、姜饼与红白条纹硬糖方块,屋顶撒着彩糖针,挂着椒盐卷饼招牌。棒棒糖与小熊软糖树排在一片绿色糖果公园旁,园中还有棉花糖塔;街道上有软糖机器人和糖果小火车,背景里一座白色糖果摩天轮在转。柔和暖棚光,粉彩色调,浅景深让最近的糖果罐保持清晰,俏皮超现实氛围,4:3。
一座用甜点搭出的微缩场景。提示词必须逐个元素写明材质,因为「糖果」才是这个效果的本体。
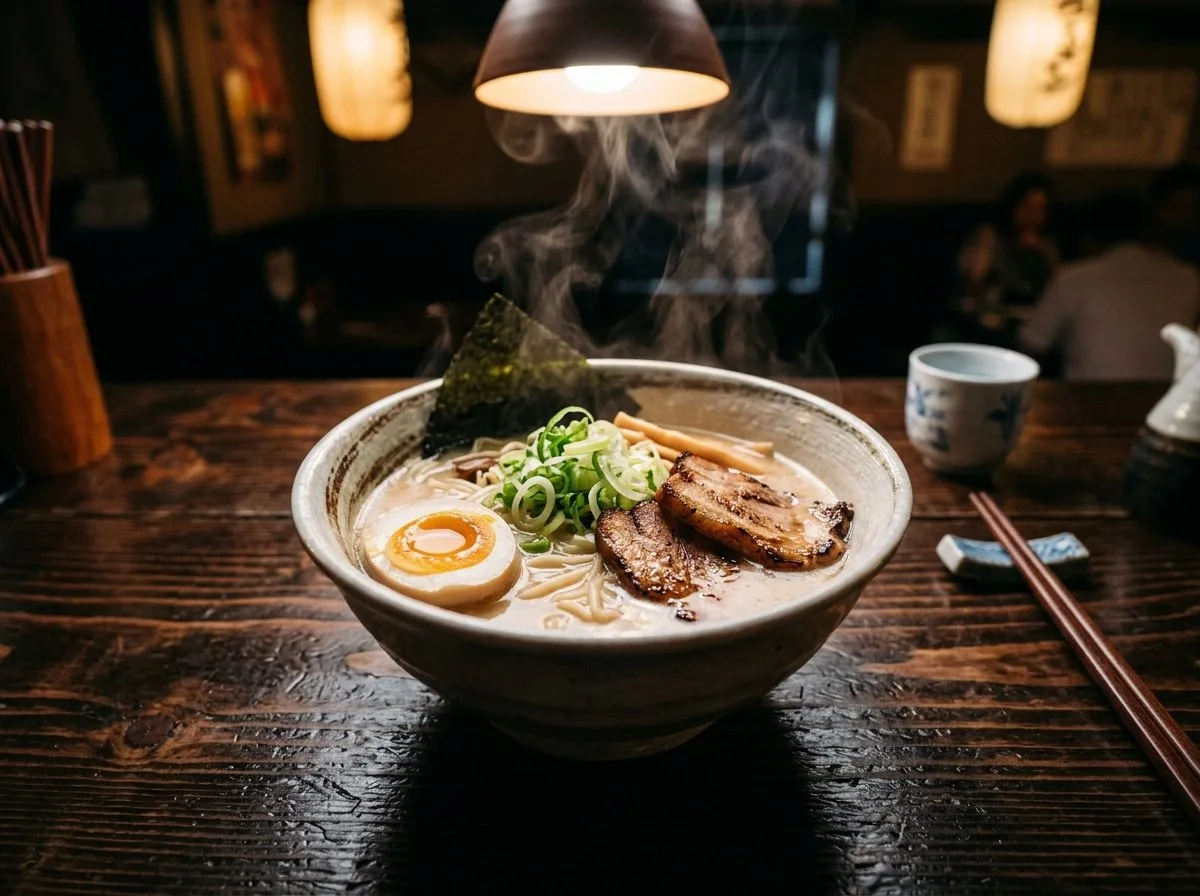
暗调餐厅静物:深色木质桌面上放着热气腾腾的豚骨拉面。浅口斑点陶碗里是乳白猪骨汤、卷曲面条、两片炙烤叉烧、半个溏心蛋、一片海苔、笋干和一撮葱花;蒸汽在光里向上卷。暖色吊灯在头顶发光,背景是模糊的食客、左侧的筷筒与折好的餐巾。暗调 50mm 大光圈,暖琥珀高光,深阴影,4:3。
一张暗调食物摄影。这里的反推重点应该先写光再写料:暖色吊灯、被照亮的热气,以及把餐厅推远的那层虚化。
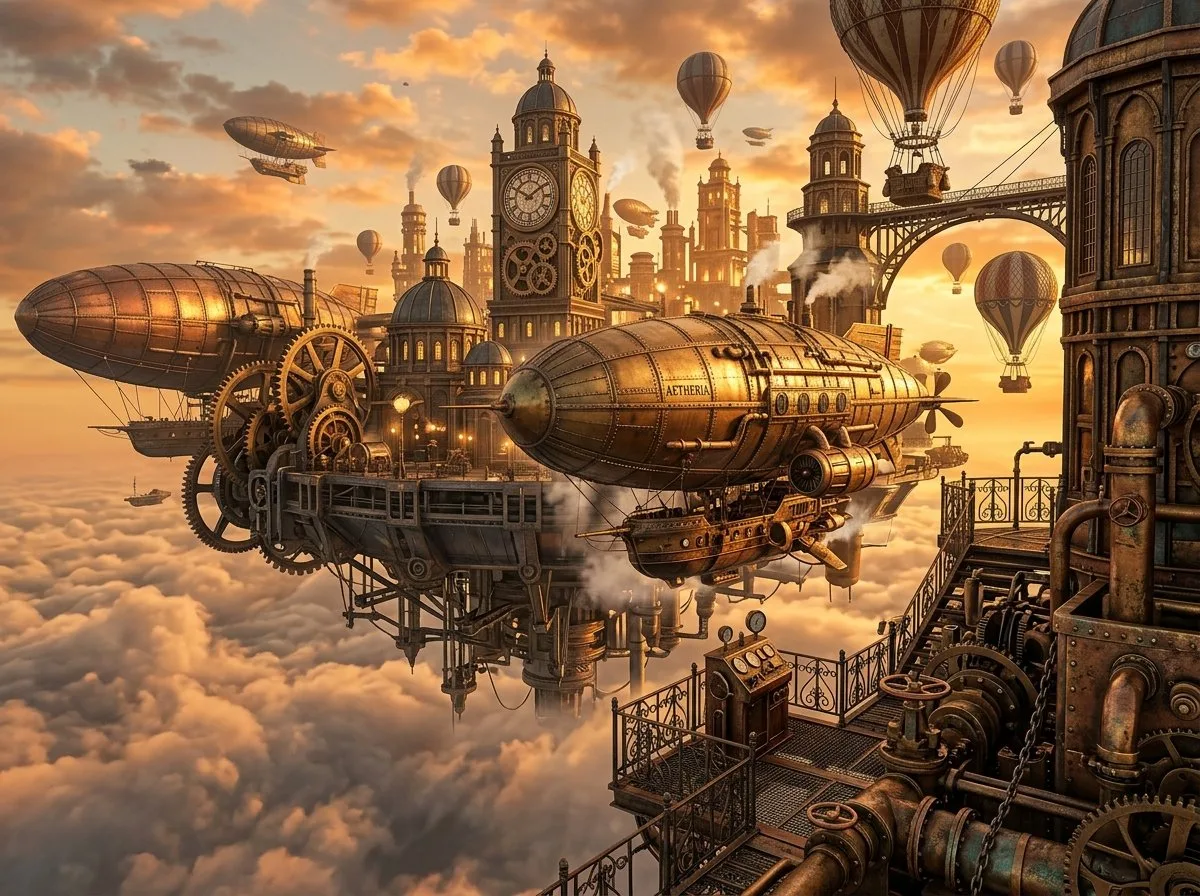
金色时刻,云海之上的蒸汽朋克城市全景。画面中右侧悬着一艘华丽的铆接黄铜飞艇,舷侧铭牌写着 AETHERIA,吊舱拖着管道与蒸汽;更小的飞艇与热气球在琥珀色光线中飘浮。左侧,一座铜穹顶、带外露齿轮的钟楼与铁桥组成的浮空平台城市从云层中升起,左上角还泊着第二艘飞艇。太阳在积云后形成眩光;右前景是布满管道、阀门、齿轮与栏杆的工业平台。超高细节数字绘画,暖铜金色调,戏剧性逆光与体积雾,电影感构图。
一张数字插画。这类画面天然需要长提示词:材质、时代、机械与光都要写出来,而画面里可读的铭牌文字值得逐字写下。
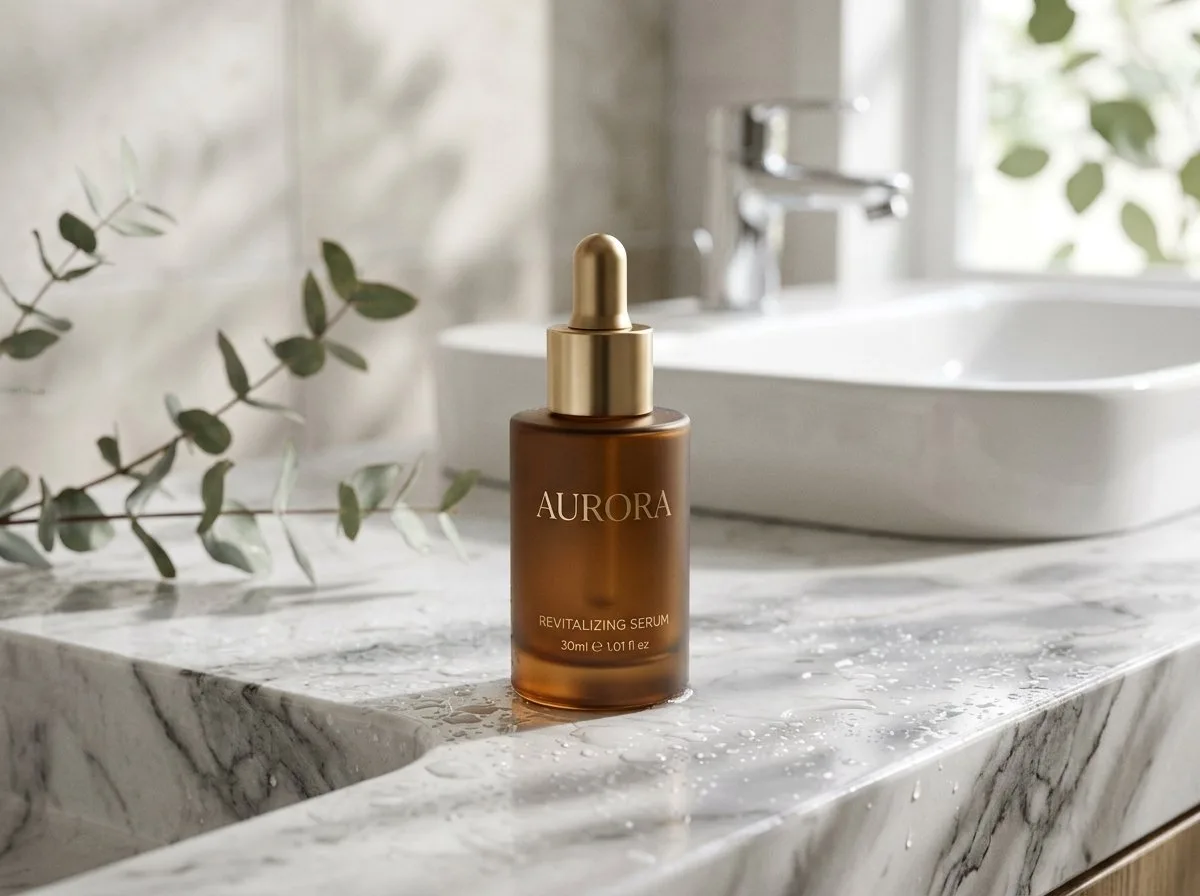
编辑风产品摄影:琥珀色玻璃滴管瓶立在湿的白色大理石台面上,表面布满水珠。瓶身是拉丝金色滴管盖与细金衬线标签,写着 AURORA,下方是 REVITALIZING SERUM 与 30 ml e 1.01 fl oz。左侧伸入一枝略微失焦的尤加利叶;其后方是白色陶瓷洗手盆与镀铬水龙头,位于明亮而虚化的浴室中,窗外有绿植。右侧斜射柔和日光,高调白、灰纹大理石与暖琥珀的配色,浅景深,电商主图构图,4:3。
一张产品图。反推提示词要复现光路与湿面反光,并且应该把标签文字逐字誊写出来。
图片反推提示词是做什么的,做不到什么
图片反推提示词工具读取画面中的可见证据——主体、构图、风格、光影、色彩与镜头感——并据此写出一段新的文字提示词。它还原不出原作者键入的那段话:除非文件里还带着生成元数据(见下文),原始提示词已经不在了。你拿到的是一次忠实的重建,不是原文。
- 能还原的是可见的东西:主体、排布、画风、光影、镜头感、色彩处理、媒介。
- 不能还原的是作者的原话、没在画面里留下痕迹的负向指令,以及采样器参数这类隐藏设置。
一次上传会返回什么
一次上传返回一段可编辑的提示词,按图像模型读取文字的顺序组织:先主体,再构图、风格与媒介,然后是光影、镜头与色彩,最后是画质与格式词。你可以把它复制进任何接受文本提示词的模型,也可以直接在本工作台的图像模型里运行。
反推提示词怎么用:四步
工作台的操作流程刻意保持很短。
- 选一张你有权处理的图片并上传。
- 按需设定分析重点——构图、主体、风格或光影——让分析偏向某一层。
- 核对服务端报价,提交,阅读返回的提示词。
- 按目标模型改写措辞,然后在本站或任何接受文本提示词的地方复用。
不同模型读提示词的顺序不一样
同一段描述,换一个模型来读,落点就不一样。图像模型并不共享同一套语法:对某一家原样可用的提示词,放进另一家就浪费了最有分量的词。下表是本工具写入时的顺序,以及各家族应该怎么改切。
| 目标模型家族 | 怎么读提示词 | 先写什么 |
|---|---|---|
| Midjourney 类 | 短语加逗号,整句散文会稀释注意力 | 主体与媒介,再接风格 |
| Stable Diffusion 家族 | 标签加权式,显式关键词胜过连接词 | 主体,再接风格标签与画质词 |
| Flux 与 Gemini 类 | 自然语言、完整句子、版面指令 | 一段通顺的场景描述 |
| 文本编辑器与智能体 | 任意结构化内容 | 一份带标签的视觉属性清单 |
有些图片的文件里还留着原始提示词
在动手反推之前,先看看提示词是不是还挂在文件里。Stable Diffusion WebUI 会把完整的正向与负向提示词、Steps、Sampler、CFG scale、Seed 和模型哈希写进 PNG 的 parameters tEXt 块;JPEG 与 WebP 导出带 EXIF UserComment;ComfyUI 则嵌入整份 workflow JSON。元数据还在的话,原始提示词可以逐字复制出来,根本不用重建。
问题是这些元数据很脆弱。重新上传到 Discord、X、Reddit、Facebook 或 Telegram 会被剥掉,截图和二次编码同样剥掉。一张在社交平台上转过手的图,几乎不会再带着它的提示词——这时才轮到按可见证据重建这条路。
四条可直接复制的提示词,按模型家族分类
反过来看:自己写提示词时值得照抄的是形状。每个家族一条,替换方括号部分即可。
editorial photograph of [主体], [场景], soft window light, 35mm, muted color grade --ar 3:2
[主体], [风格] style, detailed texture, cinematic lighting, sharp focus, [色调], high detail
一幅[媒介],画的是[场景]里的[主体]。构图把[关键元素]放在前景;光线是[光影描述];色调偏[色彩]。整体呈现[镜头或相机质感]。
[景别]的[主体],[动作或姿态],穿着[细节],在[环境]里,[时间],[光影描述],[风格参照],[画幅比例]
免费、免登录、无限次:这些词在这里是什么意思
搜这个关键词,结果里全是宣称免费、无限次、无需注册的工具。那是它们的口号,不是本站的口径。在这里,每次请求提交前都会展示服务端报价,任务账本是最终扣点记录。本站不宣传「无限次」,因为不存在无限次——能调用什么、按什么价格,始终由实时目录决定。
结果能有多接近,会在哪里跑偏
返回的提示词强在看得见的部分:主体、构图、媒介、光影、色彩。跑偏的是没有活进像素里的部分:画面里渲染的文字、品牌标识、负向指令,以及原始工具没有外传的任何参数。一个有用的边界案例是 Midjourney:它的 seed 是 0 到 4294967295 之间的整数,只能对自己发起的任务取回,而且不携带风格——所以没有任何工具能从一张 Midjourney 图里读出能复现这个 look 的 seed。
- 接近:主体、姿态、构图、画风、光影、色彩处理。
- 跑偏:画面内文字、标识、负向提示词、采样器或引导系数这类隐藏设置。
除了照搬风格,还有六种用法
输出是纯文本,哪里需要描述,哪里就能用。
- 给无障碍或内容库写替代文本与图注。
- 风格连续性:把固定画风描述一次,系列里反复复用。
- 练习写提示词:看一种你喜欢的 look 如何拆解成词。
- 原始提示词丢了之后,给自己生成过的图补一份文字档案。
- 情绪板分析:把参考图变成可横向比较的文本。
- 交接需求:给设计师或客户一份精确的参考图描述。
权利、授权与真人照片
只上传你有权处理的图片。处理真人照片前先取得授权,也不要把结果用于冒充任何人。品牌标识与商标角色在两个方向上都要同样谨慎——你上传的图里有,你复用的提示词里也可能有。工具的输出不会授予你本来没有的任何权利。
常见问题
它能还原原始提示词吗?
不能。它根据画面中的可见证据写一段新的描述。只有当原始提示词还随文件元数据一起存在时——PNG parameters 块、EXIF UserComment 或 ComfyUI workflow——才可能逐字取回。
它能从 PNG 里提取提示词吗?
可以,前提是 PNG 还带着 Stable Diffusion WebUI 或 ComfyUI 写入的生成元数据。重新上传到社交平台、截图和二次编码都会把元数据剥掉,流传过的文件通常已经没有;这时工具改为按可见证据重建。
结果能在本站图像模型里复用吗?
可以。提示词就是纯文本,复制到本站图像工作台即可使用,也可以先改写;生成效果取决于目标模型与你的设置。
返回的提示词是按哪个模型家族写的?
默认顺序适合自然语言模型。正文中「不同模型读提示词的顺序」一节给出了短语式与标签式家族的改切方法。
反推出来的提示词有多准?
可见属性——主体、构图、风格、光影、色彩——最强;画面内文字、标识和任何没在最终像素里留痕的东西最弱。合理预期是一次接近的重建,不是逐字还原。
拿到 Midjourney seed 就能复现一张图吗?
不能。seed 是 0 到 4294967295 之间的整数,只能对自己发起的任务取回,而且不携带风格。没有任何工具能从 seed 里读回一个 look。
我上传的图片会怎样?
图片只用于完成你在本工作台内的任务,本站不会发布用户上传的内容。请只处理你有权使用的图片。
费用怎么算?
每次请求提交前都会展示服务端报价,服务端账本是最终扣点记录。可调用项目与价格由实时目录决定。
这里免费吗?有无限次数吗?
不免费,也没有无限次——通常这样承诺的页面会把成本藏在别处。本站每次请求提交前先报价,你先确认价格再提交。
可以上传真人照片吗?
只有在拥有相应权利与授权时才可以,且不得把结果用于冒充他人。详见正文的权利一节。
继续探索
Nano Banana 2.1
本站 Nano Banana 2.1 实际开放的模式、目录公布的参数与限制、提示词写法、常见失败恢复,以及与 Nano Banana 2、Lite 的选型依据。
Nano Banana 2
Nano Banana 2 即 Gemini 3.1 Flash Image:支持 4K 输出、14 张参考图、图中文字与联网检索接地。官方规格、边界与提示词框架,附家族选型表。
GPT Image 2.5
用 GPT Image 2.5(ChatGPT Images 2.5)生成或编辑图像:较 GPT Image 2 提速最高 50%,支持精准局部编辑与 3,840 px 输出。规格、定价与提示词写法见内文。