 Gemini 4 Link
Gemini 4 Argon 獨立實測:Google 自測表沒寫的東西,第三方測出來了
Google 在 2026 年 9 月 30 日發布了自家的一張跑分對照表。同一天,Artificial Analysis 用自己的一套評測也跑了一遍 Argon 並公布了結果。兩張表回答的其實是兩個問題。
第二張表在同一天出現
Google 在 2026 年 9 月 30 日的公告末尾附了一張十八行的對照表。同一天,Artificial Analysis 也給出了自己對這款模型的讀數,用的是它自己跑的評測,而不是廠商提供的數字。
在 Artificial Analysis 的智能指數上,Gemini 4 Argon 在高推理檔位拿到 53 分,與 max 檔的 GPT-6 Astra 持平,比 GPT-6.1 Sol 高 1 分。和 Google 自己近一年半的成績比,跨度更大,比 Gemini 3.1 Pro Preview 的 30 分高 23 分,比 Gemini 3.8 Flash 高 12 分。
這份獨立報告由此得出一個結論,Google 重新回到智能水平前三的位置。Argon 也是 Google 七個多月來第一款高於 Flash 級別的閉源模型,這和 Google 旗艦線十個月的空窗正好對上。
本文數字來自 Google 2026 年 9 月 30 日的 Gemini 4 Argon 公告,以及 Artificial Analysis 同日發布的獨立評測結果。

為什麼這一輪要等獨立評測
發布前三週,一個標註為 gemini-3.8-flash 的匿名模型出現在公開競技場的盲測裡,在程式碼、圖形與智慧體任務上明顯強過真正的 Gemini 3.8 Flash。開發者普遍推斷這就是 Gemini 4 的早期版本,但顯示名一直沒有變,Google 也從未認領。
2026 年 9 月 18 日流傳出的一張基準圖,把這個未確認的模型排在 GPT-6 Astra 與 Claude Fable 5.1 之前,涵蓋長流程程式開發與電腦操作,還附了一份據稱的定價。這些數字在多家媒體之間轉了一圈,始終沒有落到一款 Google 真正點名過的模型上。
這並不是說那張流出的圖是錯的,而是說它無法被驗證。9 月 30 日出現的東西性質不同,它帶著公開的評測框架、寫明的推理檔位,以及一份可以拿去對照公開價目表的成本數字。
- 競技場上的那個馬甲顯示為 gemini-3.8-flash,Google 從未確認過它的身分。
- 流傳的基準圖日期是 2026 年 9 月 18 日,比正式發布早十二天。
- Artificial Analysis 自己跑評測,不轉述廠商提供的數字。
每個任務 1.99 美元,便宜來自價目表
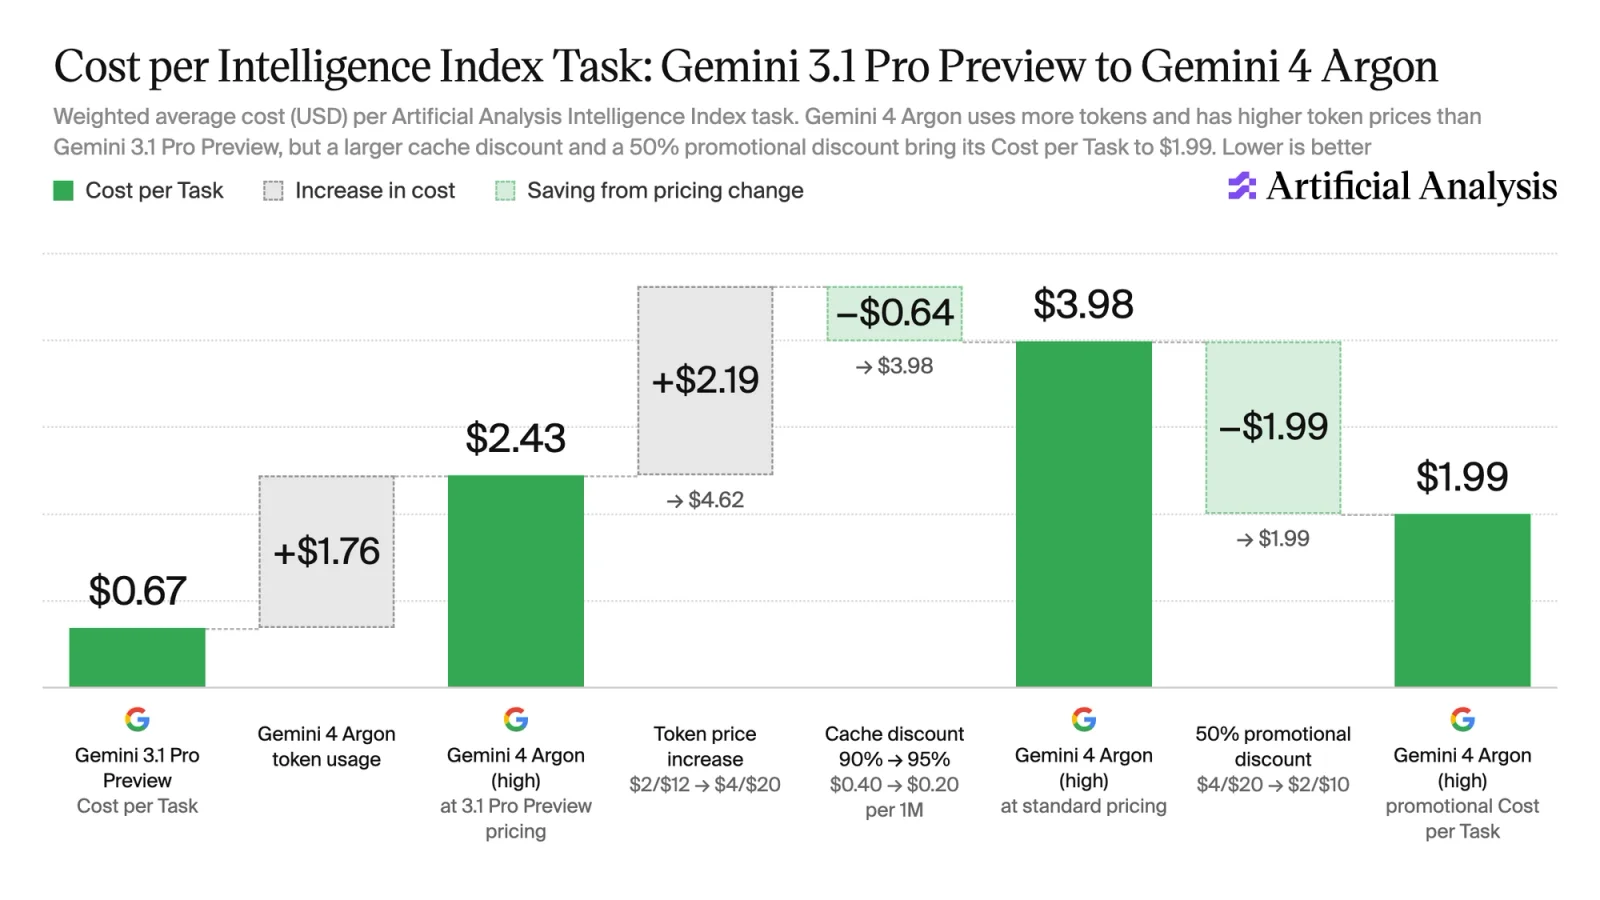
預算真正在意的是每個任務的成本。按目前五折的上市優惠價,Gemini 4 Argon 每個智能指數任務花 1.99 美元,max 檔的 GPT-6 Astra 是 3.26 美元。在智能水平相近的前提下,Argon 只花了對手六成的錢。
但和更便宜的那款 OpenAI 模型比,方向就反過來了。同一個評測裡,GPT-6.1 Sol 的每任務成本比 Argon 低 2.7 倍。而優惠一旦結束,Argon 的數字會升到 3.98 美元,變成 GPT-6 Astra 的 1.2 倍,不再便宜。
原因不在效率。Argon 平均每個任務輸出約 6.2 萬 token,GPT-6 Astra 只有 2.7 萬,它是靠花更多 token 換到同樣的分數,贏在單價上。快取輸入也變便宜了,折扣從 Gemini 3.8 Flash 的九折優惠提到 95%。
| 方案 | 每百萬 token 輸入 / 輸出 | 每個智能指數任務成本 |
|---|---|---|
| Gemini 4 Argon(high)優惠價 | 2 / 10 美元 | 1.99 美元 |
| Gemini 4 Argon(high)標準價 | 4 / 20 美元 | 3.98 美元 |
| GPT-6 Astra(max) | 10 / 50 美元 | 3.26 美元 |
| GPT-6.1 Sol(max) | 官方未按同一口徑公布 | 約 0.74 美元,換算所得 |
Sol 那一行並不是官方公布的每任務成本,而是用報告裡給出的 2.7 倍關係對 1.99 美元反推出來的,放在這裡只是為了看方向,不能當作報價使用。
15% 的幻覺率,同級最低
這份獨立報告裡最鋒利的結論不是能力分數。在 AA-Omniscience 上,這項評測同時考察答得對與不知道時肯不肯說不知道,Gemini 4 Argon 的幻覺率是 15%,是智能指數 45 分以上所有模型裡最低的一個,對比之下 GPT-6 Astra 是 51%,GPT-6.1 Sol 是 54%。
把準確率那一半放進來,畫面就更細。Argon 答對的比例是 50%,比 Gemini 3.1 Pro Preview 低 5 分,比 GPT-6 Astra 的 63% 低 13 分。而在 AA-Omniscience 的綜合分上,三款模型只差 1 分以內,Argon 與 Sol 是 42 分,Astra 是 43 分。
這個拆分說明的是一款寧可拒答也不硬猜的模型。對於無人值守、要連續跑很長任務鏈的工作來說,答錯的代價比答不出更高,所以指數記錄下來的這個取捨,價值大過頭條上的能力提升。

智慧體能力大幅補課,但還不是第一
上一代 Gemini 最弱的一環就是智慧體,這次獨立跑分顯示補課幅度不小。Gemini 4 Argon 在 AutomationBench-AA 上以 78% 排第一,領先 max 檔的 Claude Sonnet 5.5 七個百分點,而這項基準考的是能否端到端跑完真實的業務流程。
終端類任務給出的是另一半答案。在 Terminal Bench 4 上,Argon 只有 57%,比 Gemini 3.1 Pro Preview 高 53 分,但同時落後三款模型,Claude Sonnet 5.5 是 64%,Claude Opus 5.5 是 60%,GPT-6 Astra 是 59%。
在考察知識工作的 AA-Briefcase 上,Argon 拿到 1494 Elo,靠的是 65% 的評分細則通過率,這也是 Artificial Analysis 記錄到的最高值。不過分項並不好看,分析品質為 1576 Elo,呈現品質只有 1308 Elo。

同一項基準,兩套結論
Terminal-bench 4.0 同時出現在兩張表裡,而它們對誰領先的說法並不一致。Google 的表把 Argon 放在 57.4%,落後 Claude Opus 5.5 九個百分點。獨立跑分把 Argon 放在 57%,落後的是 Claude Sonnet 5.5 的 64%,Opus 5.5 是 60%,GPT-6 Astra 是 59%。Argon 自己的分數幾乎一樣,圍繞它的說法卻完全不同。
廠商表格也是某些結果的唯一出處。Harvey 法律智慧體基準只在那裡出現,Argon 19.6%,GPT-6 Astra 是 5.4%,Claude Opus 5.5 是 3.8%。考察 256k 到 1M 超長上下文的 GraphWalks 也只在官方口徑下顯示出超過十個百分點以上的領先。這兩項都還沒有獨立重現。
兩張表回答的是不同的問題。廠商表說明的是在廠商自己選定的框架與設定下,模型能做到什麼。獨立表說明的是換個人來跑,它又是什麼樣。對一款仍然只開放給審核過合作方的模型來說,沒有消費者入口,也沒有任何可以被重複的對話,只有後一種數字能被房間外的人核查。
| Terminal-bench 4.0 | Google 公布的表格 | Artificial Analysis 實跑 |
|---|---|---|
| Gemini 4 Argon | 57.4% | 57% |
| Claude Opus 5.5 | 66.4%,該表中的領先者 | 60% |
| Claude Sonnet 5.5 | 未列入 | 64%,本次實跑的領先者 |
| GPT-6 Astra | 不是該行最高的那個點 | 59% |
兩張表都沒有錯。它們的評測框架、提示詞與推理檔位都不一樣,這正是為什麼單獨一個排名數字從來不該被單獨看待。
拿到第二份意見之後該怎麼做
還有一個獨立細節解釋了長鏈路任務為什麼變得可行。Artificial Analysis 測試了一個叫 Long Decode Continuation 的 Gemini API 特性,它會把長回應暫停,再透過後續呼叫續寫,所以推理可以跑到 100 萬輸出 token 而不觸發請求逾時,上一代的輸出上限是 6.4 萬。上下文窗口為 100 萬 token,輸入支援文字、圖像、影片與語音,輸出為文字。
開放範圍並沒有因為這些資料而改變。Argon 仍然只給 Fairwind 計畫中經過審核的防禦機構,付費 API 客戶與 Google AI Ultra 訂閱者是下一批,沒有日期。上面所有結果現在都無法在一般帳號裡重現,這也是把兩張表都當作方向性參考的最強理由。
等待期裡真正值得做的事,正好是獨立數字獎勵的那一件。拿今天能呼叫的模型建一套固定提示詞,把輸出記下來,等 Argon 開放後用同一套題原樣重跑。一款新模型和你自己的基線比,比它和任何別人的表比都更有意義,包括這一篇。
- Argon 目前只能透過 Fairwind 計畫接觸。
- 輸出上限從 6.4 萬 token 提升到 100 萬 token。
- 現在建好的固定提示詞集合,是日後測試 Argon 最省事的方式。
常見問題
Gemini 4 Argon 的獨立跑分是多少?
Artificial Analysis 在自家智能指數上給出 53 分,與 GPT-6 Astra 的 53 分持平,比 GPT-6.1 Sol 的 52 分高 1 分。這個分數比 Gemini 3.1 Pro Preview 高 23 分,比 Gemini 3.8 Flash 高 12 分。
為什麼獨立跑分和 Google 官方數字不一樣?
因為兩者測的不是同一件事。廠商表格報的是自家設定下跑出來的成績,Artificial Analysis 用自己的評測集、提示詞與評分器重跑一遍,推理檔位與外圍封裝都可能不同,即使基準名稱一樣也是如此。
Gemini 4 Argon 每個任務要花多少錢?
按目前五折優惠價,Artificial Analysis 測得每個智能指數任務 1.99 美元,同檔推理下的 GPT-6 Astra 是 3.26 美元。優惠結束後同一任務升到 3.98 美元,約為 GPT-6 Astra 的 1.2 倍。
為什麼 Argon 用的 token 更多反而更便宜?
因為折扣打在單價上,不是打在用量上。Argon 平均每個任務輸出約 6.2 萬 token,GPT-6 Astra 是 2.7 萬,所以省錢來自更低的單價,而不是做得更少。
15% 的幻覺率是什麼水準?
在 AA-Omniscience 上為 15%,是智能指數 45 分以上模型裡最低的一個。GPT-6 Astra 是 51%,GPT-6.1 Sol 是 54%。不過它的準確率只有 50%,低於 GPT-6 Astra 的 63%。
Gemini 4 Argon 的智慧體能力是最強的嗎?
還不是。它在 AutomationBench-AA 上以 78% 排第一,領先 Claude Sonnet 5.5 七個百分點。但在 Terminal Bench 4 上只有 57%,落後 Claude Sonnet 5.5 的 64%、Claude Opus 5.5 的 60% 與 GPT-6 Astra 的 59%。
100 萬 token 輸出上限是怎麼實現的?
靠一個叫 Long Decode Continuation 的 Gemini API 特性。它會把長回應暫停,再透過後續呼叫續寫,所以推理可以跑到 100 萬輸出 token 而不觸發請求逾時。上一代的輸出上限是 6.4 萬 token。
本站現在能呼叫 Gemini 4 Argon 嗎?
不能。Argon 目前只開放給 Fairwind 計畫中經過審核的防禦機構,付費 API 客戶與 Google AI Ultra 訂閱者是下一批,沒有時間表。本站工作臺跑的是 Gemini 3.8 Flash,也是目前真正能呼叫的模型。