 Gemini 4 Link
Gemini 4 Argon a examen: lo que encuentran las pruebas independientes y la tabla de Google omite
Google publicó su propia tabla de pruebas el 30 de septiembre de 2026. Artificial Analysis publicó ese mismo día una segunda lectura del mismo modelo, construida con evaluaciones que ejecuta por su cuenta. Las dos tablas responden a preguntas distintas.
La segunda tabla llegó el mismo día
Google cerró su anuncio el 30 de septiembre de 2026 con una tabla comparativa de dieciocho filas. Artificial Analysis publicó ese mismo día su propia lectura del mismo modelo, construida con evaluaciones que ejecuta ella misma en lugar de cifras facilitadas por el proveedor.
En el Intelligence Index de Artificial Analysis, Gemini 4 Argon obtiene 53 con su ajuste de razonamiento alto. Eso empata con GPT-6 Astra en razonamiento máximo y queda un punto por delante de GPT-6.1 Sol. La distancia frente al historial reciente de Google es mayor: Argon está 23 puntos por encima de Gemini 3.1 Pro Preview con 30 y 12 puntos por encima de Gemini 3.8 Flash.
El informe independiente extrae una conclusión de eso. Google vuelve a estar entre los tres mejores laboratorios en inteligencia medida. Argon es además el primer modelo propietario de Google por encima de la clase Flash en más de siete meses, lo que encaja con el hueco de diez meses en la cronología insignia de Google.
Las cifras de este artículo proceden del anuncio de Google sobre Gemini 4 Argon del 30 de septiembre de 2026 y de Artificial Analysis, que publicó sus propios resultados de evaluación ese mismo día.

Por qué una ejecución independiente era lo que había que esperar
Tres semanas antes del lanzamiento, un modelo anónimo etiquetado como gemini-3.8-flash apareció en batallas a ciegas de una arena pública y superó con claridad al Gemini 3.8 Flash real en prompts de programación, diagramas y tareas agénticas. Los desarrolladores dieron por hecho que era un Gemini 4 temprano, pero el nombre mostrado nunca cambió y Google nunca lo reclamó.
Un gráfico de pruebas que circuló el 18 de septiembre de 2026 situaba al modelo no confirmado por delante de GPT-6 Astra y Claude Fable 5.1 en programación de largo recorrido y uso de ordenador, con un precio filtrado adjunto. Los números pasaron por varios medios antes de que nadie pudiera atarlos a un modelo que Google hubiera nombrado de verdad.
Nada de eso hace que el gráfico filtrado sea falso. Lo hace inverificable. Lo que llegó el 30 de septiembre es de otra clase, porque trae un armazón publicado, un ajuste de razonamiento declarado y una cifra de coste que puede contrastarse con la lista pública de precios por token.
- El alias de la arena se mostraba como gemini-3.8-flash y Google nunca lo confirmó.
- El gráfico que circulaba estaba fechado el 18 de septiembre de 2026, doce días antes del lanzamiento.
- Artificial Analysis ejecuta sus propias evaluaciones en lugar de reimprimir cifras del proveedor.
1,99 dólares por tarea, y el ahorro viene de la lista de precios
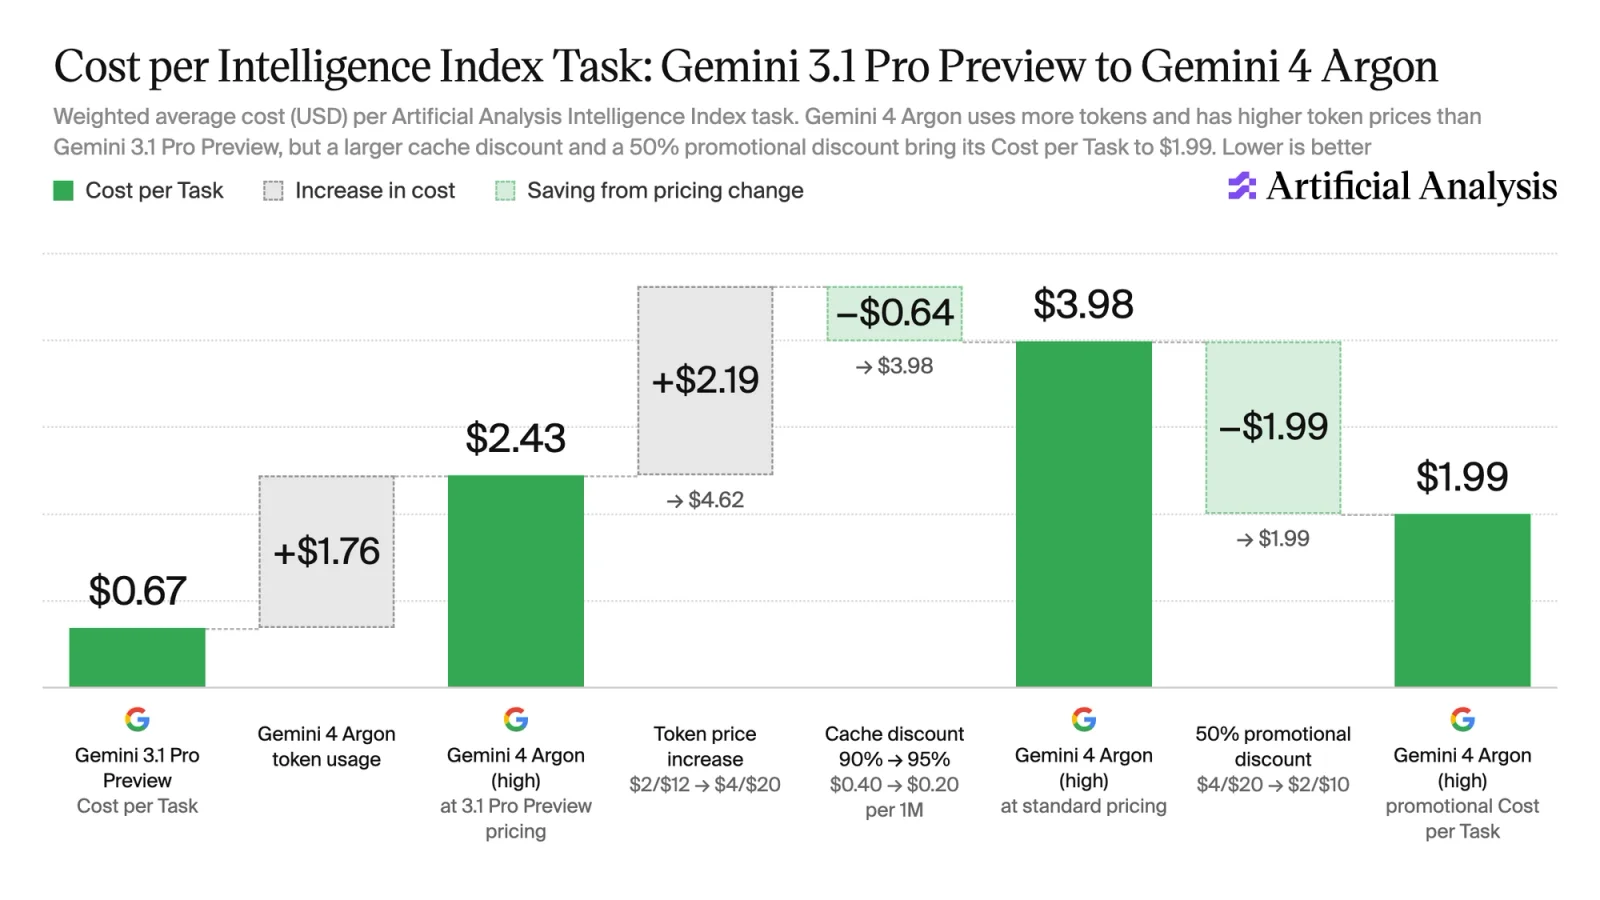
El coste por tarea es la cifra que nota un presupuesto. Con el descuento de lanzamiento actual del 50 por ciento, Gemini 4 Argon cuesta 1,99 dólares por tarea del Intelligence Index frente a 3,26 dólares de GPT-6 Astra con razonamiento máximo, o el 60 por ciento del precio por un nivel comparable de inteligencia medida.
La comparación se invierte frente al modelo más barato de OpenAI. En la misma evaluación GPT-6.1 Sol cuesta 2,7 veces menos por tarea que Argon. Cuando terminen los precios promocionales, la cifra de Argon sube a 3,98 dólares, más o menos 1,2 veces GPT-6 Astra en lugar de un descuento frente a él.
La causa no es la eficiencia. Argon promedia unos 62.000 tokens de salida por tarea donde GPT-6 Astra promedia 27.000, así que gasta más tokens para llegar a la misma puntuación y gana por precio unitario. La entrada en caché también salió más barata, pasando de un descuento del 90 por ciento en Gemini 3.8 Flash a un 95 por ciento en Argon.
| Opción | Entrada / salida por millón de tokens | Coste por tarea del Intelligence Index |
|---|---|---|
| Gemini 4 Argon (high), promocional | 2 / 10 USD | 1,99 USD |
| Gemini 4 Argon (high), estándar | 4 / 20 USD | 3,98 USD |
| GPT-6 Astra (max) | 10 / 50 USD | 3,26 USD |
| GPT-6.1 Sol (max) | No publicado en la misma unidad | Unos 0,74 USD, derivado |
La cifra de Sol no se publica como coste por tarea. Se deriva de la relación declarada de 2,7 veces aplicada al resultado de 1,99 dólares de Argon, y se incluye para mostrar una dirección, no como presupuesto.
Un 15 por ciento de alucinación, el más bajo de su clase
El resultado más afilado del informe independiente no es una puntuación de capacidad. En AA-Omniscience, que mezcla la exactitud factual con la disposición a declinar cuando el modelo no sabe, Gemini 4 Argon registra un 15 por ciento de alucinación. Es el más bajo de cualquier modelo con 45 puntos o más en el Intelligence Index, frente al 51 por ciento de GPT-6 Astra en max y el 54 por ciento de GPT-6.1 Sol.
Leído junto al lado de la exactitud, el cuadro se vuelve más sutil. Argon responde correctamente el 50 por ciento de las veces, cinco puntos por debajo de Gemini 3.1 Pro Preview y trece puntos por debajo de GPT-6 Astra con un 63 por ciento. En la puntuación combinada de AA-Omniscience los tres modelos quedan a menos de un punto entre sí, con Argon y Sol en 42 y Astra en 43.
La división describe un modelo que declina en lugar de adivinar. En trabajo que se ejecuta sin supervisión a lo largo de cadenas largas, una respuesta equivocada cuesta más que una ausente, lo que hace que el intercambio que registra el índice valga más que la mejora de capacidad del titular.

El trabajo agéntico mejoró mucho y sigue sin liderar
La capacidad agéntica era el punto débil de la generación anterior de Gemini, y la ejecución independiente muestra un salto grande. Gemini 4 Argon lidera AutomationBench-AA con un 78 por ciento, siete puntos por delante de Claude Sonnet 5.5 en razonamiento máximo, en una prueba construida con flujos de negocio reales de extremo a extremo.
El trabajo de terminal cuenta la otra mitad. En Terminal Bench 4, Argon obtiene un 57 por ciento, 53 puntos por encima de Gemini 3.1 Pro Preview y aun así por detrás de tres modelos a la vez: Claude Sonnet 5.5 con un 64 por ciento, Claude Opus 5.5 con un 60 por ciento y GPT-6 Astra con un 59 por ciento.
En AA-Briefcase, una evaluación de trabajo de conocimiento, Argon alcanza 1.494 Elo gracias a una tasa de aprobación de rúbrica del 65 por ciento, la más alta que Artificial Analysis ha registrado. Las puntuaciones parciales son menos halagüeñas: calidad analítica en 1.576 Elo y calidad de presentación en 1.308 Elo.

La misma prueba, dos titulares distintos
Terminal-bench 4.0 aparece en las dos tablas y las dos no coinciden en quién lidera. La tabla de Google pone a Argon en un 57,4 por ciento, nueve puntos por detrás de Claude Opus 5.5. La ejecución independiente pone a Argon en un 57 por ciento, por detrás de Claude Sonnet 5.5 con un 64 por ciento, con Opus 5.5 en un 60 por ciento y GPT-6 Astra en un 59 por ciento. La puntuación de Argon es casi idéntica y el relato que la rodea no.
La tabla del proveedor es además el único lugar donde algunos resultados existen. Harvey's Legal Agent Benchmark aparece ahí con Argon en un 19,6 por ciento frente a GPT-6 Astra con un 5,4 por ciento y Claude Opus 5.5 con un 3,8 por ciento, y la evaluación de contexto largo GraphWalks muestra una ventaja de más de diez puntos en la ventana de 256k a 1M. Ninguna de las dos se ha replicado de forma independiente.
Las dos tablas responden a preguntas distintas. Una tabla de proveedor muestra lo que un modelo puede hacer cuando el proveedor elige el armazón y los ajustes. Una tabla independiente muestra lo que hace cuando los elige otro. Para un modelo aún limitado a socios verificados, sin acceso de consumidor y sin sesión que nadie pueda repetir, solo el segundo tipo puede comprobarlo alguien de fuera de la sala.
| Terminal-bench 4.0 | Tabla publicada por Google | Ejecución de Artificial Analysis |
|---|---|---|
| Gemini 4 Argon | 57,4 % | 57 % |
| Claude Opus 5.5 | 66,4 %, el líder de esa tabla | 60 % |
| Claude Sonnet 5.5 | No incluido | 64 %, el líder de esta ejecución |
| GPT-6 Astra | No es el punto líder de la fila | 59 % |
Ninguna de las dos tablas está equivocada. Se produjeron con armazones, prompts y ajustes de razonamiento distintos, y por eso precisamente un único número de clasificación nunca debería leerse solo.
Qué hacer con la segunda opinión
Un detalle independiente más explica por qué las cadenas largas se volvieron prácticas. Artificial Analysis probó una función de la API de Gemini llamada Long Decode Continuation, que pausa una respuesta larga y la reanuda en llamadas posteriores. El razonamiento puede así llegar hasta 1.000.000 de tokens de salida sin que la solicitud agote el tiempo, frente a un techo de salida de 64.000 en la generación anterior. La ventana de contexto es de 1 M de tokens, con entrada de texto, imagen, vídeo y voz y salida de texto.
El acceso no se ha movido con nada de esto. Argon sigue limitado a socios verificados de Fairwind, con los clientes de pago de la API y los suscriptores de Google AI Ultra como siguientes grupos y sin fecha. Ninguno de los resultados anteriores puede reproducirse todavía en una cuenta normal, que es el argumento más fuerte para tratar ambas tablas como direccionales.
El movimiento práctico durante la espera es el que premian los números independientes. Construye un conjunto fijo de prompts con los modelos que puedes invocar hoy, guarda las salidas y vuelve a ejecutar exactamente el mismo conjunto cuando Argon abra. Un modelo nuevo medido contra tu propia referencia dice más que ese mismo modelo medido contra la tabla de cualquier otro, incluida esta.
- Hoy solo se puede llegar a Argon a través del programa Fairwind.
- El techo de salida pasa de 64.000 a 1.000.000 de tokens.
- Un conjunto fijo de prompts creado ahora es la forma más barata de probar Argon después.
Preguntas frecuentes
¿Qué puntuación obtiene Gemini 4 Argon en pruebas independientes?
Artificial Analysis le da 53 en su Intelligence Index con el ajuste de razonamiento alto, igual que GPT-6 Astra con 53 y un punto por delante de GPT-6.1 Sol con 52. Son 23 puntos más que Gemini 3.1 Pro Preview y 12 más que Gemini 3.8 Flash.
¿Por qué difieren los números independientes de los de Google?
Miden cosas distintas. Una tabla de proveedor informa de cómo rinde un modelo en evaluaciones que el proveedor ejecutó con sus propios ajustes. Artificial Analysis usa su propio armazón, sus propios prompts y su propia corrección, así que el esfuerzo de razonamiento y el andamiaje pueden diferir aunque la prueba lleve el mismo nombre.
¿Cuánto cuesta Gemini 4 Argon por tarea?
Con el descuento actual del 50 por ciento, Artificial Analysis mide 1,99 dólares por tarea del Intelligence Index, frente a 3,26 dólares de GPT-6 Astra con razonamiento máximo. Con el precio estándar esa misma tarea sube a 3,98 dólares, más o menos 1,2 veces GPT-6 Astra.
¿Por qué Argon es más barato si gasta más tokens?
Porque el descuento se aplica al precio de un token, no a cuántos se usan. Gemini 4 Argon promedia unos 62.000 tokens de salida por tarea donde GPT-6 Astra promedia 27.000, así que el ahorro viene de un precio unitario más bajo y no de hacer menos trabajo.
¿Qué tan baja es la tasa de alucinación?
Un 15 por ciento en AA-Omniscience, la más baja de cualquier modelo con 45 puntos o más en el Intelligence Index. GPT-6 Astra está en el 51 por ciento y GPT-6.1 Sol en el 54 por ciento. Argon responde correctamente el 50 por ciento de las veces, por debajo de GPT-6 Astra con un 63 por ciento.
¿Es Gemini 4 Argon el mejor modelo para trabajo agéntico?
Todavía no. Lidera AutomationBench-AA con un 78 por ciento, siete puntos por delante de Claude Sonnet 5.5. En Terminal Bench 4 obtiene un 57 por ciento, por detrás de Claude Sonnet 5.5 con un 64 por ciento, Claude Opus 5.5 con un 60 por ciento y GPT-6 Astra con un 59 por ciento.
¿Qué hace práctico un límite de salida de 1 M de tokens?
Una función de la API de Gemini llamada Long Decode Continuation pausa una respuesta larga y la reanuda en llamadas posteriores, de modo que el razonamiento puede llegar hasta 1.000.000 de tokens de salida sin que la solicitud agote el tiempo. La generación anterior limitaba la salida a 64.000 tokens.
¿Puedo invocar Gemini 4 Argon aquí?
No. Argon está limitado a socios verificados de Fairwind, con los clientes de pago de la API y los suscriptores de Google AI Ultra como siguientes grupos y sin fecha. El espacio de chat de este sitio ejecuta Gemini 3.8 Flash, el modelo que puede invocar hoy.
Mídelo contra tu propia referencia
El espacio de chat lista los modelos que tu cuenta puede invocar, con un presupuesto del servidor antes de cada solicitud.
Abrir el espacio de chat