 Gemini 4 Link
Gemini 4 Argon em análise: o que os testes independentes encontram e a tabela da Google omite
A Google publicou a sua própria tabela de testes em 30 de setembro de 2026. A Artificial Analysis publicou nesse mesmo dia uma segunda leitura do mesmo modelo, construída a partir de avaliações que executa por conta própria. As duas tabelas respondem a perguntas diferentes.
A segunda tabela chegou no mesmo dia
A Google fechou o seu anúncio a 30 de setembro de 2026 com uma tabela comparativa de dezoito linhas. A Artificial Analysis publicou no mesmo dia a sua própria leitura do mesmo modelo, construída a partir de avaliações que ela própria corre, em vez de números fornecidos pelo fabricante.
No Intelligence Index da Artificial Analysis, o Gemini 4 Argon obtém 53 com a definição de raciocínio alta. Isso empata com o GPT-6 Astra em raciocínio máximo e fica um ponto à frente do GPT-6.1 Sol. A distância face ao historial recente da Google é maior: o Argon está 23 pontos acima do Gemini 3.1 Pro Preview com 30 e 12 pontos acima do Gemini 3.8 Flash.
O relatório independente retira daí uma conclusão. A Google regressa como um dos três melhores laboratórios em inteligência medida. O Argon é ainda o primeiro modelo proprietário da Google acima da classe Flash em mais de sete meses, o que encaixa no intervalo de dez meses na cronologia de topo da Google.
Os números deste artigo vêm do anúncio da Google sobre o Gemini 4 Argon de 30 de setembro de 2026 e da Artificial Analysis, que publicou os seus próprios resultados de avaliação no mesmo dia.

Porque é que uma execução independente era o que havia para esperar
Três semanas antes do lançamento, um modelo anónimo etiquetado como gemini-3.8-flash apareceu em batalhas cegas numa arena pública e superou claramente o verdadeiro Gemini 3.8 Flash em prompts de programação, diagramas e tarefas agênticas. Os programadores assumiram amplamente que era um Gemini 4 inicial, mas o nome mostrado nunca mudou e a Google nunca o reclamou.
Um gráfico de testes que circulou a 18 de setembro de 2026 colocava o modelo não confirmado à frente do GPT-6 Astra e do Claude Fable 5.1 em programação de longo curso e utilização de computador, com um preço alegadamente associado. Os números passaram por vários órgãos antes de alguém conseguir ligá-los a um modelo que a Google tivesse realmente nomeado.
Nada disso torna o gráfico divulgado errado. Torna-o não verificável. O que chegou a 30 de setembro é de outra natureza, porque traz uma estrutura publicada, uma definição de raciocínio declarada e um valor de custo que pode ser confrontado com a lista pública de preços por token.
- O alias da arena era apresentado como gemini-3.8-flash e nunca foi confirmado pela Google.
- O gráfico que circulava estava datado de 18 de setembro de 2026, doze dias antes do lançamento.
- A Artificial Analysis corre as suas próprias avaliações em vez de reimprimir números do fabricante.
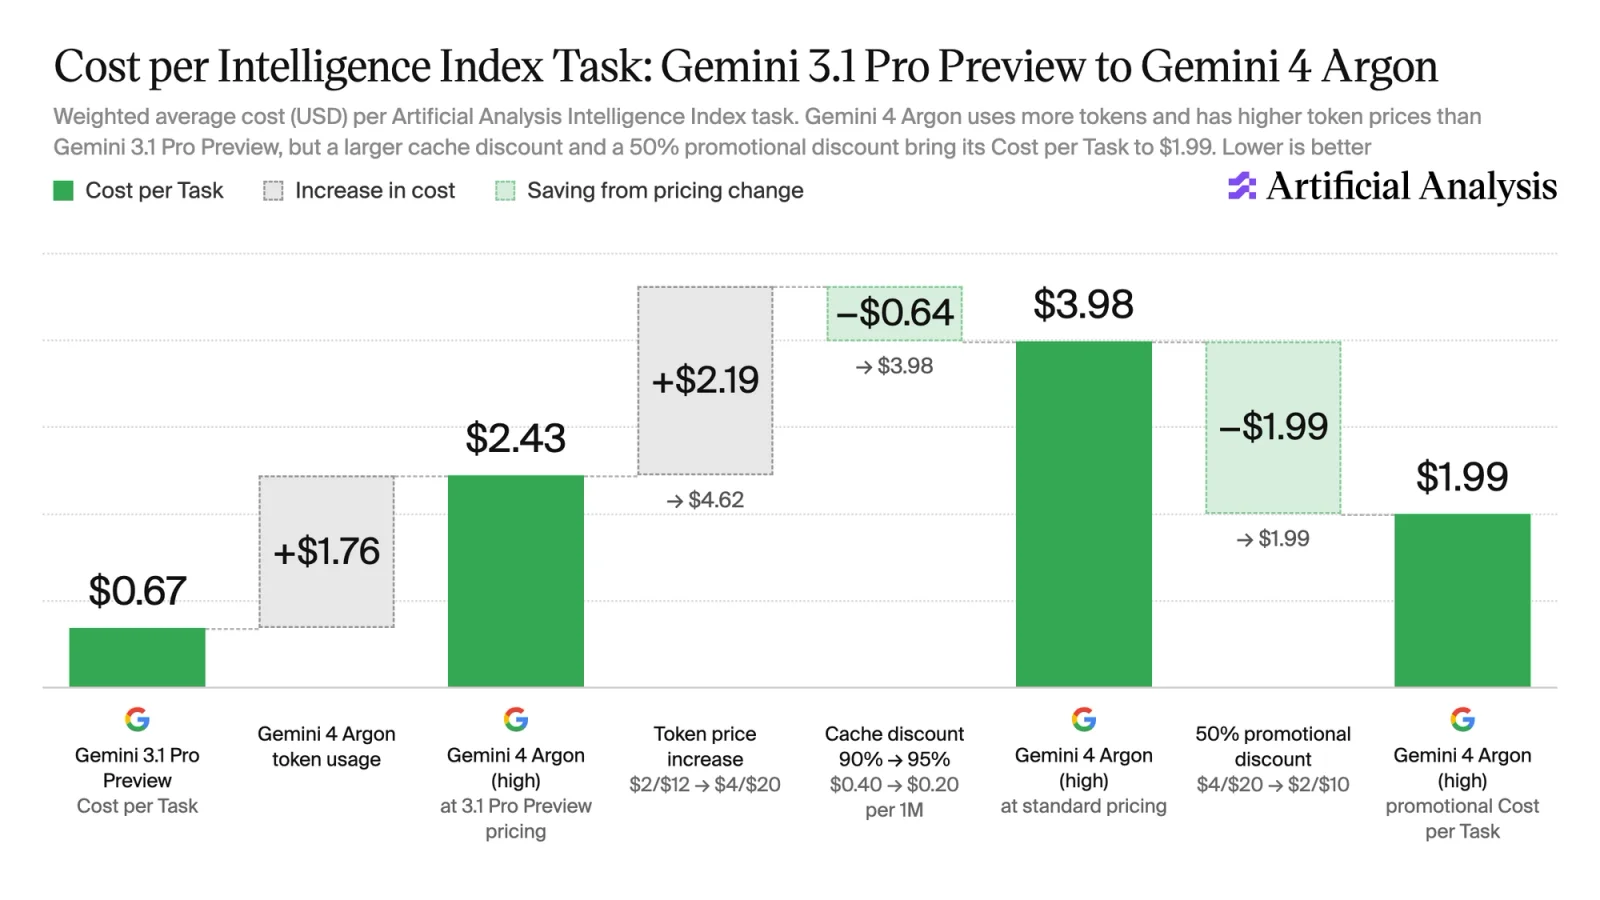
1,99 dólares por tarefa, e a poupança vem da lista de preços
O custo por tarefa é o número que um orçamento nota. Com o desconto de lançamento atual de 50 por cento, o Gemini 4 Argon custa 1,99 dólares por tarefa do Intelligence Index contra 3,26 dólares do GPT-6 Astra com raciocínio máximo, ou 60 por cento do preço por um nível comparável de inteligência medida.
A comparação inverte-se face ao modelo mais barato da OpenAI. Na mesma avaliação, o GPT-6.1 Sol custa 2,7 vezes menos por tarefa do que o Argon. Quando os preços promocionais terminarem, o valor do Argon sobe para 3,98 dólares, cerca de 1,2 vezes o GPT-6 Astra em vez de um desconto face a ele.
A causa não é eficiência. O Argon gasta em média cerca de 62.000 tokens de saída por tarefa, enquanto o GPT-6 Astra gasta 27.000, pelo que gasta mais tokens para chegar à mesma pontuação e ganha no preço unitário. A entrada em cache também ficou mais barata, passando de um desconto de 90 por cento no Gemini 3.8 Flash para 95 por cento no Argon.
| Opção | Entrada / saída por milhão de tokens | Custo por tarefa do Intelligence Index |
|---|---|---|
| Gemini 4 Argon (high), promocional | 2 / 10 USD | 1,99 USD |
| Gemini 4 Argon (high), padrão | 4 / 20 USD | 3,98 USD |
| GPT-6 Astra (max) | 10 / 50 USD | 3,26 USD |
| GPT-6.1 Sol (max) | Não publicado na mesma unidade | Cerca de 0,74 USD, derivado |
O valor do Sol não é publicado como custo por tarefa. É derivado da relação declarada de 2,7 vezes aplicada ao resultado de 1,99 dólares do Argon, e é incluído para mostrar uma direção, não como orçamento.
15 por cento de alucinação, a mais baixa da sua classe
O resultado mais incisivo do relatório independente não é uma pontuação de capacidade. No AA-Omniscience, que mistura exatidão factual com a disposição para recusar quando o modelo não sabe, o Gemini 4 Argon regista 15 por cento de alucinação. É a mais baixa de qualquer modelo com 45 pontos ou mais no Intelligence Index, contra 51 por cento do GPT-6 Astra em max e 54 por cento do GPT-6.1 Sol.
Lido ao lado da exatidão, o quadro torna-se mais subtil. O Argon responde corretamente em 50 por cento dos casos, cinco pontos abaixo do Gemini 3.1 Pro Preview e treze pontos abaixo do GPT-6 Astra com 63 por cento. Na pontuação combinada do AA-Omniscience, os três modelos ficam a menos de um ponto uns dos outros, com o Argon e o Sol em 42 e o Astra em 43.
A divisão descreve um modelo que recusa em vez de adivinhar. Em trabalho que corre sem supervisão ao longo de cadeias longas, uma resposta errada custa mais do que uma ausente, o que torna a troca que o índice registra mais valiosa do que o ganho de capacidade do título.

O trabalho agêntico melhorou muito e continua a não liderar
A capacidade agêntica era o ponto fraco da geração anterior do Gemini, e a execução independente mostra um salto grande. O Gemini 4 Argon lidera o AutomationBench-AA com 78 por cento, sete pontos à frente do Claude Sonnet 5.5 em raciocínio máximo, num teste construído a partir de processos de negócio reais de ponta a ponta.
O trabalho de terminal conta a outra metade. No Terminal Bench 4, o Argon obtém 57 por cento, 53 pontos acima do Gemini 3.1 Pro Preview e ainda assim atrás de três modelos ao mesmo tempo: Claude Sonnet 5.5 com 64 por cento, Claude Opus 5.5 com 60 por cento e GPT-6 Astra com 59 por cento.
No AA-Briefcase, uma avaliação de trabalho de conhecimento, o Argon alcança 1.494 Elo com base numa taxa de aprovação de rubrica de 65 por cento, a mais alta que a Artificial Analysis registou. As pontuações parciais são menos lisonjeiras, com qualidade analítica em 1.576 Elo e qualidade de apresentação em 1.308 Elo.

O mesmo teste, dois títulos diferentes
O Terminal-bench 4.0 aparece nas duas tabelas e as duas não concordam sobre quem lidera. A tabela da Google coloca o Argon em 57,4 por cento, nove pontos atrás do Claude Opus 5.5. A execução independente coloca o Argon em 57 por cento, atrás do Claude Sonnet 5.5 com 64 por cento, com o Opus 5.5 em 60 por cento e o GPT-6 Astra em 59 por cento. A pontuação do Argon é quase idêntica e a história à sua volta não.
A tabela do fabricante é também o único sítio onde alguns resultados existem. O Harvey's Legal Agent Benchmark aparece lá com o Argon em 19,6 por cento contra o GPT-6 Astra com 5,4 por cento e o Claude Opus 5.5 com 3,8 por cento, e a avaliação de contexto longo GraphWalks mostra uma vantagem superior a dez pontos na janela de 256k a 1M. Nenhuma das duas foi replicada de forma independente.
As duas tabelas respondem a perguntas diferentes. Uma tabela de fabricante mostra o que um modelo consegue fazer quando o fabricante escolhe a estrutura e as definições. Uma tabela independente mostra o que ele faz quando é outra pessoa a escolher. Para um modelo ainda limitado a parceiros verificados, sem acesso de consumidor e sem sessão que alguém possa repetir, só o segundo tipo pode ser verificado por quem está fora da sala.
| Terminal-bench 4.0 | Tabela publicada pela Google | Execução da Artificial Analysis |
|---|---|---|
| Gemini 4 Argon | 57,4 % | 57 % |
| Claude Opus 5.5 | 66,4 %, o líder dessa tabela | 60 % |
| Claude Sonnet 5.5 | Não incluído | 64 %, o líder desta execução |
| GPT-6 Astra | Não é o ponto líder da linha | 59 % |
Nenhuma das tabelas está errada. Foram produzidas com estruturas, prompts e definições de raciocínio diferentes, e é exatamente por isso que um único número de classificação nunca deve ser lido sozinho.
O que fazer com a segunda opinião
Mais um detalhe independente explica porque as cadeias longas se tornaram práticas. A Artificial Analysis testou uma função da API Gemini chamada Long Decode Continuation, que pausa uma resposta longa e retoma-a em chamadas seguintes. O raciocínio pode assim ir até 1.000.000 de tokens de saída sem que o pedido esgote o tempo, contra um teto de saída de 64.000 na geração anterior. A janela de contexto é de 1 M de tokens, com entrada de texto, imagem, vídeo e voz e saída de texto.
O acesso não mudou com nada disto. O Argon continua limitado a parceiros Fairwind verificados, com os clientes pagos da API e os subscritores do Google AI Ultra nomeados como grupos seguintes e sem data. Nenhum dos resultados acima pode ser reproduzido numa conta comum, o que é o argumento mais forte para tratar as duas tabelas como direcionais.
O movimento prático durante a espera é o que os números independentes recompensam. Construa um conjunto fixo de prompts com os modelos que consegue invocar hoje, guarde as saídas e volte a correr exatamente o mesmo conjunto quando o Argon abrir. Um modelo novo medido contra a sua própria referência diz mais do que esse mesmo modelo medido contra a tabela de qualquer outra pessoa, incluindo esta.
- Hoje só se chega ao Argon através do programa Fairwind.
- O teto de saída passa de 64.000 para 1.000.000 de tokens.
- Um conjunto fixo de prompts criado agora é a forma mais barata de testar o Argon mais tarde.
Perguntas frequentes
Que pontuação obtém o Gemini 4 Argon em testes independentes?
A Artificial Analysis atribui-lhe 53 no seu Intelligence Index com a definição de raciocínio alta, igual ao GPT-6 Astra com 53 e um ponto à frente do GPT-6.1 Sol com 52. São 23 pontos acima do Gemini 3.1 Pro Preview e 12 acima do Gemini 3.8 Flash.
Porque é que os números independentes diferem dos da Google?
Medem coisas diferentes. Uma tabela de fornecedor relata o desempenho de um modelo em avaliações que o fornecedor correu com as suas próprias definições. A Artificial Analysis usa a sua própria estrutura, os seus próprios prompts e a sua própria classificação, pelo que o esforço de raciocínio e o andaime podem diferir mesmo quando o teste tem o mesmo nome.
Quanto custa o Gemini 4 Argon por tarefa?
Com o desconto atual de 50 por cento, a Artificial Analysis mede 1,99 dólares por tarefa do Intelligence Index, contra 3,26 dólares do GPT-6 Astra com raciocínio máximo. Ao preço padrão essa mesma tarefa sobe para 3,98 dólares, cerca de 1,2 vezes o GPT-6 Astra.
Porque é que o Argon é mais barato se gasta mais tokens?
Porque o desconto incide no preço de um token, não em quantos são usados. O Gemini 4 Argon gasta em média cerca de 62.000 tokens de saída por tarefa, enquanto o GPT-6 Astra gasta 27.000, pelo que a poupança vem de um preço unitário mais baixo e não de fazer menos trabalho.
Quão baixa é a taxa de alucinação?
15 por cento no AA-Omniscience, a mais baixa de qualquer modelo com 45 pontos ou mais no Intelligence Index. O GPT-6 Astra está em 51 por cento e o GPT-6.1 Sol em 54 por cento. O Argon responde corretamente em 50 por cento dos casos, abaixo do GPT-6 Astra com 63 por cento.
O Gemini 4 Argon é o melhor modelo para trabalho agêntico?
Ainda não. Lidera o AutomationBench-AA com 78 por cento, sete pontos à frente do Claude Sonnet 5.5. No Terminal Bench 4 obtém 57 por cento, atrás do Claude Sonnet 5.5 com 64 por cento, do Claude Opus 5.5 com 60 por cento e do GPT-6 Astra com 59 por cento.
O que torna prático um limite de saída de 1 M de tokens?
Uma função da API Gemini chamada Long Decode Continuation pausa uma resposta longa e retoma-a em chamadas seguintes, pelo que o raciocínio pode ir até 1.000.000 de tokens de saída sem que o pedido esgote o tempo. A geração anterior limitava a saída a 64.000 tokens.
Posso invocar o Gemini 4 Argon aqui?
Não. O Argon está limitado a parceiros Fairwind verificados, com os clientes pagos da API e os subscritores do Google AI Ultra nomeados como grupos seguintes e sem data. O espaço de chat deste site corre o Gemini 3.8 Flash, o modelo que consegue invocar hoje.
Meça-o contra a sua própria referência
O espaço de chat lista os modelos que a sua conta consegue invocar, com um orçamento do servidor antes de cada pedido.
Abrir o espaço de chat